
Jev ของ TypeSafe AI เจาะลึกโมเดลตัดสินใจ: วิธีทำงาน ความมั่นใจ และข้อจำกัด
ถ้าระบบต้องการเพียงคำตอบว่า ‘ส่งเรื่องให้ทีมไหน’ การให้ AI เขียนข้อความยาวแล้วแปลงกลับเป็นคำสั่งอาจเพิ่มงานที่ไม่จำเป็น Jev ของ TypeSafe AI เสนอให้ส่งสถานการณ์และคำถามที่กำหนดชนิดคำตอบไว้ แล้วรับตัวเลือก คะแนน หรือความน่าจะเป็นกลับมาโดยตรง ความน่าสนใจจึงอยู่ทั้งที่ความเร็วและวิธีแบ่งหน้าที่ระหว่างโมเดลกับโค้ด แต่ต้องอ่านคำว่า confidence, calibrated และ type-safe ให้ถูกก่อนนำไปใช้ตัดสินใจแทนคน
Jev คืออะไร และเหมาะกับปัญหาแบบไหน
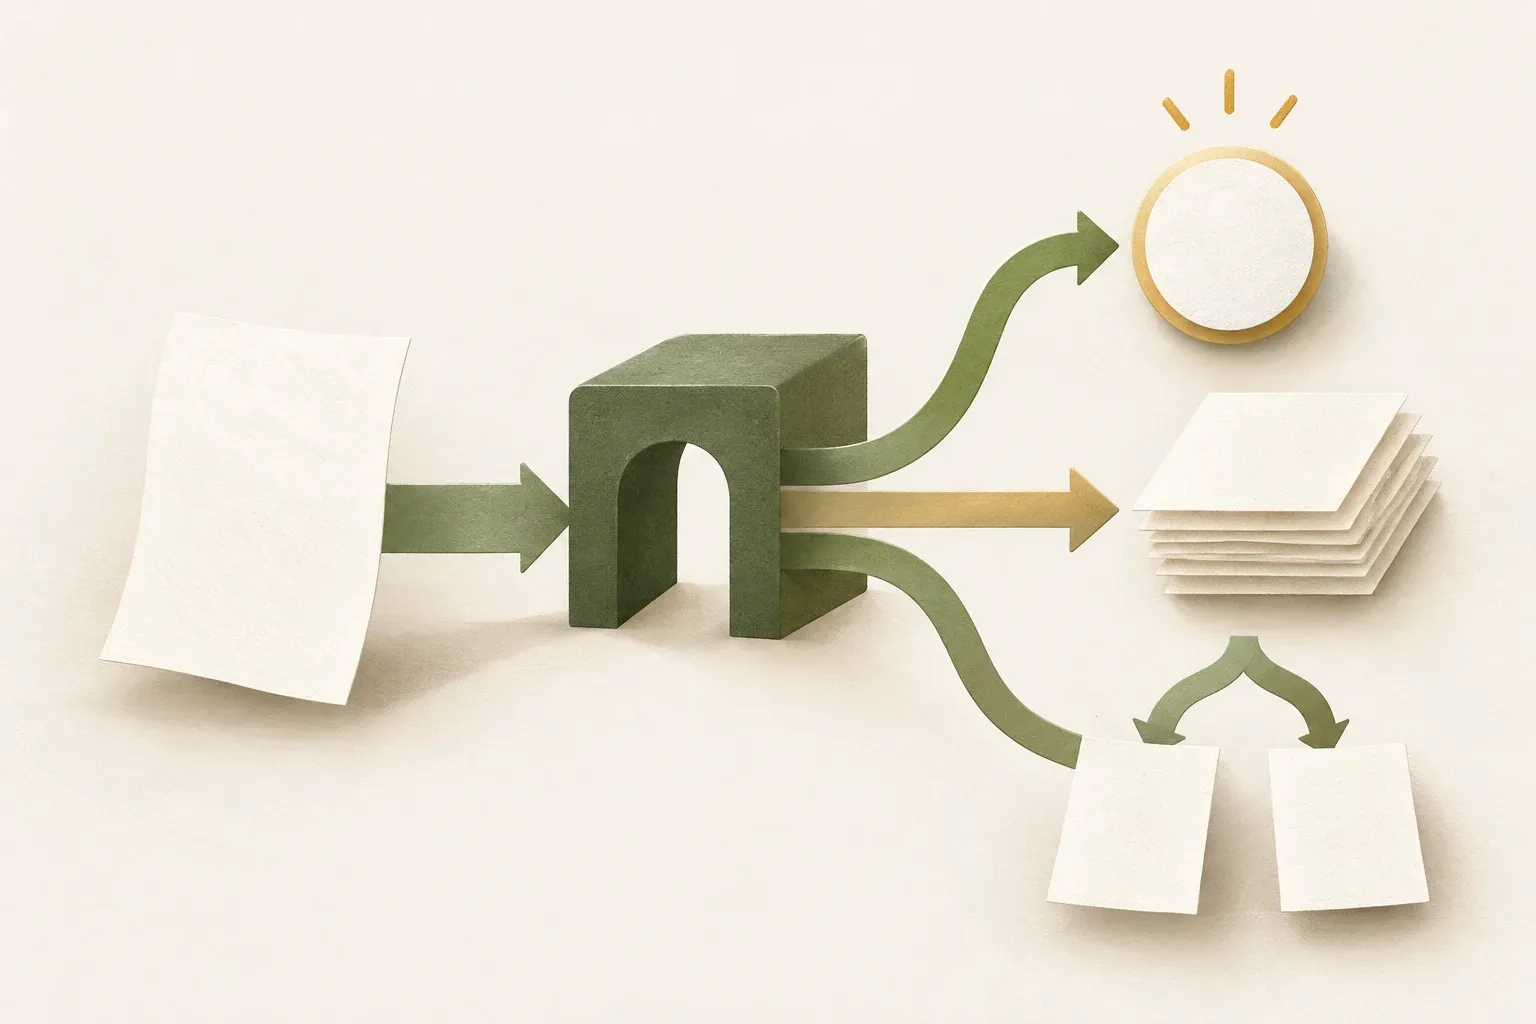
Jev คือโมเดลของ TypeSafe AI ที่รับบริบทกับคำถามแบบกำหนดชนิด แล้วคืนคำตอบที่ซอฟต์แวร์นำไปใช้ได้ทันที เช่น เลือกหมวดหมู่จากรายการ ให้คะแนนตามเกณฑ์ หรือประเมินความน่าจะเป็นของคำตอบใช่/ไม่ใช่ เอกสารเรียกโมเดลกลุ่มนี้ว่า System One models และวาง Jev เป็นโมเดลหลักของบริษัท ดู คำอธิบาย Jev จาก TypeSafe
ให้นึกถึงระบบรับแจ้งปัญหา ผู้ใช้พิมพ์ว่า “ย่อรูปแล้วภาพเบลอ อยากให้ขนาดเล็กลงแต่ยังอ่านตัวหนังสือได้” ระบบต้องรู้ว่าเกี่ยวกับรูปภาพ เป็นคำถามเรื่องคุณภาพ และควรส่งไปหาคู่มือใด คำตอบที่มีประโยชน์กับโปรแกรมคือรหัสหมวดและระดับความแน่ใจ มากกว่าคำอธิบายหลายย่อหน้า Jev ออกแบบมารับบทตัดสินใจย่อยลักษณะนี้
จุดที่ต้องแยกให้ชัดคือ การตัดสินใจไม่เท่ากับการลงมือทำ Jev ไม่ได้มีสิทธิ์อ่านฐานข้อมูล ส่งเงิน หรือลบไฟล์เพราะตอบชื่อการกระทำออกมา โปรแกรมรอบโมเดลต้องตรวจสิทธิ์ ตรวจเงื่อนไข และเรียกเครื่องมือเอง ความน่าเชื่อถือของระบบจึงขึ้นกับทั้งโมเดลและการออกแบบโค้ด
ในมุมของ KrobClick คุณค่าที่ควรประเมินคือ Jev ช่วยแทนกฎที่เปราะบางต่อภาษามนุษย์ได้มากแค่ไหน เช่น การจับเจตนาที่ใช้คำต่างกัน ส่วนสูตรคำนวณ จำนวนเงิน ขนาดไฟล์ และเงื่อนไขที่นิยามแน่นอนยังควรใช้โค้ดตามปกติ
หน้า Models ที่ตรวจวันที่ 29 ตุลาคม 2569 เพิ่ม Jev 1.14 (jev-1.14.0) ซึ่งเปิดวันที่ 14 ตุลาคม 2569 แล้ว บทความยังคงตัวอย่าง API และข้อจำกัดแบบ jaggedness ของ Jev 1.13 ตามแหล่งที่อ้าง ไม่ได้ยืนยันว่าปัญหาเหล่านั้นคงเดิมหรือหายไปใน 1.14 หากเปลี่ยนรุ่น ให้ทดสอบข้อมูลเดิมและเกณฑ์ตัดสินใหม่ก่อนใช้แทน
System One และ RLCD บอกอะไรเราได้บ้าง
TypeSafe ใช้แนวคิด System 1 ที่รวดเร็วและอาศัยการประเมินทันที มาเป็นภาพเปรียบเทียบของงานตัดสินใจขอบเขตแคบ ชื่อ Jev อ้างถึง William Stanley Jevons และแนวคิดว่าต้นทุนการใช้ทรัพยากรที่ลดลงอาจเปิดให้เกิดความต้องการใช้มากขึ้น ทั้งสองเป็นที่มาของชื่อ ไม่ใช่หลักฐานว่าโมเดลจำลองสมองหรือพิสูจน์กฎเศรษฐศาสตร์ได้ ดู ประกาศเปิดตัวและคำอธิบายชื่อ
บริษัทอธิบายแนวทางฝึกว่า Reinforcement Learning for Calibrated Decisions หรือ RLCD โดยเน้นคำตอบที่มีโครงสร้างและความน่าจะเป็นที่สัมพันธ์กับผลจริง แทนการเน้นข้อความที่คนชอบอ่าน เอกสารเปรียบเทียบกับ RLHF ซึ่งใช้ feedback ความชอบของมนุษย์ และ RLVR ซึ่งใช้รางวัลจากผลที่ตรวจสอบได้ นี่เป็นกรอบอธิบายแนวทางของ TypeSafe ไม่ควรตีความว่าโมเดลทุกตัวในแต่ละกลุ่มมีพฤติกรรมเหมือนกันทั้งหมด ดู AI primer และแนวคิด RLCD
คำว่า calibrated อธิบายคุณสมบัติของคำทำนายจำนวนมาก ตัวอย่างสมมติ: ถ้าระบบให้ความน่าจะเป็น 0.8 กับเหตุการณ์ชนิดหนึ่งในหลายกรณี เหตุการณ์นั้นควรเกิดประมาณ 80% ในกลุ่มดังกล่าวเมื่อปรับเทียบได้ดี ไม่ได้แปลว่ากรณีใดกรณีหนึ่งถูกแน่นอน และการปรับเทียบดีในข้อมูลชุดหนึ่งก็ต้องตรวจซ้ำเมื่อเปลี่ยนภาษา โดเมน หรือเกณฑ์คำถาม
ขอบเขตที่เรายืนยันได้จากเอกสารที่ใช้อ้างอิงคือรูปแบบอินพุต เอาต์พุต และคำอธิบายแนวทางฝึกของผู้พัฒนา บทความนี้ไม่ได้ตรวจน้ำหนักโมเดล ชุดข้อมูลฝึก หรือทำซ้ำกระบวนการฝึก จึงไม่สรุปสถาปัตยกรรมภายในว่าเป็น BERT ที่เปลี่ยนชื่อ หรือเป็นสิ่งที่ไม่เกี่ยวกับโมเดลภาษาเลยจากรูปร่าง API เพียงอย่างเดียว
ความต่างจาก structured outputs ต้องวัดมากกว่าการได้ JSON
TypeSafe วางจุดต่างไว้ที่โมเดลตัดสินใจและการคืนผลแบบขนาน ในการเลือกใช้งานจริง KrobClick เสนอให้เทียบกับ LLM ที่รองรับ schema ตามความสามารถที่บริการนั้นรับประกัน อย่าเทียบเฉพาะกับการขอให้แชต “ตอบเป็น JSON” แล้วสรุปว่าทางเลือกทั้งหมดควบคุมรูปแบบไม่ได้ การคืน JSON ที่ถูกโครงสร้างกับการทำนายที่ถูกต้องเป็นคนละแกนของการประเมิน
คำถามสำหรับผู้เลือกใช้จึงมีอย่างน้อยสามข้อ: คำตอบอยู่ในชุดที่อนุญาตเสมอหรือไม่ ความน่าจะเป็นสัมพันธ์กับผลจริงหรือไม่ และเมื่อทำงานเดียวกันทั้ง workflow แล้วเร็วหรือประหยัดกว่าเพียงใด แม้สองบริการคืนคำตอบหน้าตาคล้ายกัน ผลบนสามแกนนี้ก็ยังต้องพิสูจน์แยกกัน
Choice, Score และ Noul ต่างกันอย่างไร
| ชนิด | โจทย์ที่เหมาะ | สิ่งที่คืนมา | สิ่งที่ต้องระวัง |
|---|---|---|---|
| Choice | เลือกหมวดหรือการกระทำจากชุดที่กำหนด | ตัวเลือก ความน่าจะเป็นทุกตัวเลือก และ confidence | ต้องมีตัวเลือกครอบคลุม รวมถึงกรณีไม่เข้าหมวด |
| Score | ประเมินหนึ่งมิติตามระดับที่เรียงลำดับ | คะแนนเฉลี่ยถ่วงน้ำหนัก การกระจาย และ confidence | คะแนนเป็นตำแหน่งบนเกณฑ์ที่กำหนด ไม่ใช่หน่วยจริง |
| Noul | ตรวจข้อความเงื่อนไขใช่/ไม่ใช่ | ค่า noul ช่วง 0–1 ซึ่งแทนความน่าจะเป็นของใช่ | ค่ากลางสื่อความไม่แน่ใจ ไม่ใช่คำตอบว่าไม่มี |
Choice: เลือกจากตัวเลือกที่โปรแกรมยอมรับ
ถ้าคำถามคือ “เรื่องนี้เกี่ยวกับ PDF รูปภาพ QR หรืออย่างอื่น” ให้ใช้ Choice โดยอธิบายความหมายของแต่ละหมวด ตัวเลือกไม่มีลำดับมากน้อย และคำตอบอยู่ในชุดที่กำหนด เอกสาร API ระบุขีดจำกัดสูงสุด 255 ตัวเลือกต่อคำถาม ดู Choice และ ข้อกำหนด API
ข้อเสนอของ KrobClick คือควรมีทางออกอย่าง other หรือ “ข้อมูลไม่พอ” เมื่อโจทย์เปิดให้มีกรณีนอกหมวด การมีคำตอบที่ชนิดถูกต้องจะช่วยระบบได้ต่อเมื่อชุดคำตอบรองรับโลกจริงด้วย หากให้เลือกเฉพาะ PDF กับ QR ข้อความเรื่องรูปภาพก็ยังอาจถูกบังคับให้ลงผิดหมวด
Score: ตัวเลขมีความหมายตามคำบรรยายระดับ
Score ใช้ระดับเรียงลำดับ โดยเลขระดับเริ่มที่ 0 ตามตำแหน่งในรายการ และคะแนนอาจอยู่ระหว่างระดับ ตัวอย่างสมมติ กำหนดความเร่งด่วนสามระดับ: “สอบถามทั่วไป” “งานติดขัดแต่มีวิธีอื่น” และ “งานหลักหยุดและไม่มีวิธีอื่น” ถ้าความน่าจะเป็นเป็น 0.1, 0.6 และ 0.3 คะแนนจะเท่ากับ 0 × 0.1 + 1 × 0.6 + 2 × 0.3 = 1.2 ดู วิธีอ่าน Score และการเขียนระดับ
ค่า 1.2 ไม่ใช่เวลาที่ต้องรอ 1.2 ชั่วโมงหรือความเสียหาย 1.2 หน่วย และคะแนนเฉลี่ยอย่างเดียวซ่อนความต่างได้: ความน่าจะเป็นทั้งหมดอยู่ที่ระดับ 1 กับครึ่งหนึ่งอยู่ที่ระดับ 0 และอีกครึ่งที่ระดับ 2 ต่างก็เฉลี่ยได้ 1 แต่ความไม่แน่ใจต่างกันมาก จึงควรอ่านการกระจายควบคู่ และใช้คำบรรยายสถานการณ์ที่แยกกันได้แทนเกณฑ์ตัวเลขล้วน ๆ
Noul: ค่าความน่าจะเป็นของคำตอบใช่
Noul เหมาะกับคำถามเดียวที่นิยามชัด เช่น “ผู้ใช้ขอให้ส่งเรื่องให้คนช่วยหรือไม่” ค่าใกล้ 1 เอนทางใช่ ใกล้ 0 เอนทางไม่ใช่ และใกล้ 0.5 แปลว่าไม่แน่ใจ คำตอบชนิดนี้ไม่มีฟิลด์ confidence แยกต่างหาก ดู Noul
ต้องเขียนเงื่อนไขให้ตรงสิ่งที่ต้องการตรวจ “ข้อความระบุว่าจ่ายเงินแล้วหรือไม่” ตรวจสิ่งที่ผู้ใช้กล่าวได้ แต่ไม่ยืนยันว่าธุรกรรมเกิดขึ้นจริง การยืนยันธุรกรรมต้องอ่านข้อมูลจากแหล่งที่มีอำนาจยืนยัน เช่น ระบบชำระเงิน
Probability กับ confidence ต้องอ่านแยกกัน
ใน Choice และ Score ค่า probabilities คือการกระจายความน่าจะเป็น ส่วน confidence เป็นสถิติที่คำนวณจากการกระจายนั้นเพื่อสรุปความแน่ใจ เอกสารไม่ได้ให้อ่าน confidence เป็นอัตราตอบถูกของแต่ละคำตอบ ดู นิยามและสูตร confidence
สำหรับ Choice ที่มี n ตัวเลือก สูตรคือ (p_max − 1/n) / (1 − 1/n) โดย p_max เป็นความน่าจะเป็นสูงสุด ตัวอย่างสมมติสามตัวเลือกที่ได้ 0.8, 0.15 และ 0.05 จะมี confidence เท่ากับ (0.8 − 1/3) / (1 − 1/3) = 0.7 จึงไม่ควรอ่าน confidence 0.7 ว่า “ตัวเลือกนี้มีโอกาสถูก 70%” เพราะตัวเลขความน่าจะเป็นที่โมเดลให้ตัวเลือกนั้นคือ 0.8
Score ใช้สูตรที่คำนึงถึงระยะห่างระหว่างระดับด้วย ความไม่แน่ใจระหว่างระดับที่อยู่ติดกันจึงต่างจากการกระจายไปสองสุดขั้ว ส่วน Noul ใช้ค่าโอกาสใช่โดยตรง ข้อเสนอของ KrobClick คือกำหนดเกณฑ์แยกตามคำถามและผลกระทบ แล้วตรวจอัตราผิดจริงของกลุ่มที่ผ่านเกณฑ์ อย่ายืม threshold จากตัวอย่างเอกสารมาเป็นค่ามาตรฐานโดยไม่ทดสอบ
ยังมีความต่างระหว่าง ความแน่ใจของโมเดล กับ ข้อมูลครบพอให้ทำงานหรือไม่ ระบบอาจมั่นใจว่าผู้ใช้ต้องการลบไฟล์ แต่ไม่มีข้อมูลว่าเป็นไฟล์ไหนหรือผู้ใช้มีสิทธิ์หรือไม่ ต้องตรวจเงื่อนไขเหล่านี้แยกต่างหาก การเพิ่ม threshold ไม่ทดแทนการตรวจสิทธิ์หรือการยืนยันการกระทำ
ตัวอย่าง API คัดแยกคำขอใช้เครื่องมือ
คำขอ HTTP ใช้ POST https://api.typesafe.ai พร้อมการยืนยันตัวตน และมีสามส่วนหลักคือ state, model และ questions ตัวอย่างต่อไปนี้เป็น JSON ที่ KrobClick ออกแบบเพื่ออธิบายโครงสร้างตาม API reference ยังไม่ได้ส่งเรียกบริการจริง และยังไม่ใช่การเชื่อม Jev เข้ากับเว็บไซต์
{
  "state": {
    "message": "อยากลดขนาดรูปให้ส่งได้ แต่ไม่อยากให้ตัวหนังสือเบลอ"
  },
  "model": "jev-1.13.0",
  "questions": {
    "tool_family": {
      "type": "choice",
      "instructions": "Choose the tool family relevant to the user's request.",
      "criteria": {
        "image": "Resize, compress, or convert images.",
        "pdf": "Work with PDF documents.",
        "qr": "Create or read QR codes.",
        "other": "None of these fits, or the request is unclear."
      }
    },
    "preserve_readability": {
      "type": "noul",
      "instructions": "Does the user explicitly ask to preserve text readability?"
    }
  }
}
เราใส่ข้อความภาษาไทยใน state และคำถามภาษาอังกฤษเพื่อให้เห็นว่าสองส่วนทำหน้าที่ต่างกัน นี่ไม่ใช่ผลพิสูจน์ว่าวิธีผสมภาษานี้แม่นที่สุด ต้องเทียบกับคำถามภาษาไทยบนข้อมูลจริงก่อนเลือกใช้ ส่วนชื่อ tool_family เป็นกุญแจสำหรับจับคู่คำตอบ เอกสาร API ระบุว่าชื่อคำถามไม่ถูกส่งให้โมเดลใช้อนุมาน จึงต้องเขียนความหมายใน instructions และ criteria ให้ครบ
State เป็นข้อความธรรมดาหรือ JSON ที่จัดบริบทเป็นฟิลด์ได้ ควรส่งเฉพาะสิ่งที่คำถามต้องใช้ เช่น ข้อความที่ต้องคัดแยกและข้อเท็จจริงที่เกี่ยวข้อง แทนประวัติผู้ใช้ทั้งหมด ดู แนวทางจัด state เมื่อได้รับคำตอบ โปรแกรมจึงตรวจว่าหมวดอยู่ในรายการที่ยอมรับ ผ่านเกณฑ์ที่ทดสอบไว้ และมีข้อมูลพอ ก่อนแสดงคู่มือหรือเส้นทางถัดไป
ตัวอย่าง Python SDK ทางการส่ง state และคำถาม Choice ก่อนอ่านตัวเลือกจากคำตอบ
from typesafe_sdk import Choice, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"document": "I was charged twice. Please fix this ASAP."},
        questions={
            "category": Choice(
                instructions="What is this ticket about?",
                criteria={"billing": None, "technical": None, "other": None},
            )
        },
    )

print(response.choices["category"].choice)
อ่านตัวอย่างนี้เทียบกับ JSON HTTP ด้านบน รูปแบบฟิลด์ของ SDK กับ HTTP อาจต่างกัน ยังไม่ได้รันตัวอย่าง จึงไม่ใช่ผลทดสอบความถูกต้องของ Jev ที่มา: เอกสารต้นทาง · MIT
ถามหลายข้อพร้อมกัน แล้วใช้โค้ดเลือกผลที่เกี่ยวข้อง
TypeSafe ออกแบบให้ถามหลายคำถามต่อ state เดียวในคำขอเดียว โดยแต่ละคำถามประเมินแยกกันแบบขนาน เอกสารเสนอรูปแบบ speculative fan-out: ถามเงื่อนไขที่อาจจำเป็นไว้พร้อมกัน แล้วให้โค้ดเลือกใช้เฉพาะผลที่สัมพันธ์กับเส้นทางจริง ดู Speculative fan-out
ตัวอย่างสมมติ ระบบรับแจ้งปัญหาอาจถามพร้อมกันว่าเป็นเรื่องเทคนิคหรือคำถามทั่วไป งานหลักหยุดหรือไม่ และมีวิธีทำซ้ำปัญหาหรือไม่ ถ้าไม่ใช่ปัญหาเทคนิค ผลเรื่องวิธีทำซ้ำก็ไม่จำเป็นต้องใช้ วิธีนี้ลดการรอคำถามทีละข้อ แต่เพิ่มรายละเอียดคำถามและยังอยู่ภายใต้งบ token จึงไม่ได้แปลว่าถามได้ไม่จำกัดโดยไม่มีต้นทุน
คำถามที่ประเมินแยกกันไม่ได้รับคำตอบของข้ออื่นมาเป็นบริบทภายในคำขอเดียว หากข้อ B ต้องอาศัยผลข้อ A ที่ยังไม่มีจริง ต้องออกแบบให้ B อ่านเงื่อนไขจาก state ได้โดยตรง หรือแยกเป็นอีกคำขอหลังรู้ผล A การส่งสองข้อพร้อมกันไม่ได้สร้างสายเหตุผลอัตโนมัติ
ข้อเสนอเชิงออกแบบของ KrobClick คือแยกสิ่งที่โมเดลควรตัดสินออกจากสิ่งที่โค้ดควรคำนวณ ตัวอย่างการจัดลำดับงานอาจให้โมเดลประเมินผลกระทบกับความเร่งด่วนคนละคำถาม แล้วแปลงคะแนนแต่ละแกนเป็นช่วง 0–1 ก่อนนำมารวมด้วยน้ำหนักที่ทีมกำหนด สูตรรวมเป็นนโยบายของระบบที่ตรวจสอบได้ ไม่ควรฝากให้โมเดลเดาน้ำหนักใหม่ในทุกคำขอ
กรณีต้องเลือกสองคุณสมบัติที่อาจเกิดพร้อมกัน เช่น “เกี่ยวกับรูปภาพ” และ “เกี่ยวกับ PDF” ควรพิจารณาหลาย Noul หรือการแบ่งงาน แทน Choice เดียวที่เลือกได้เพียงหมวดเดียว การเลือกรูปแบบคำถามเป็นส่วนหนึ่งของนิยามปัญหา ไม่ใช่รายละเอียดที่แก้ด้วยโมเดลที่ฉลาดขึ้นอย่างเดียว
ใช้กับ AI agent และ RAG ตรงไหน
เอกสารเสนอให้ Jev เป็นตัวคัดแยกหน้า workflow เช่น ส่งคำขอไปยังการค้นฐานข้อมูล โมเดลเฉพาะงาน หรือคนช่วย โดยไม่จำเป็นต้องใช้โมเดลเขียนข้อความขนาดใหญ่ตัดสินทุกขั้น ดู Intent routing
ในระบบ agent อาจให้โมเดลสร้างแผนหรือเสนอเครื่องมือ แล้วให้ Jev ประเมินคำถามแคบ เช่น “การกระทำนี้เกี่ยวข้องกับเป้าหมายที่ระบุหรือไม่” ก่อนให้โค้ดตรวจรายการเครื่องมือที่อนุญาต แต่การมีโมเดลตรวจอีกตัวไม่ได้ทำให้ระบบปลอดภัยโดยอัตโนมัติ ทั้งสองอาจถูกชักนำด้วยข้อมูลเดียวกัน จึงยังต้องมีข้อจำกัดสิทธิ์และการตรวจผลที่ไม่พึ่งโมเดล ดูหลักคิดเพิ่มเติมใน การออกแบบ Zero Trust สำหรับ AI agents
สำหรับ Retrieval-Augmented Generation หรือ RAG ข้อเสนอของ KrobClick คือทดลองใช้ Jev หลังค้นเอกสารเบื้องต้นแล้ว เพื่อประเมินว่าแต่ละชิ้นตอบคำถามได้ตรงเพียงใด จากนั้นส่งเฉพาะชิ้นที่ผ่านเกณฑ์ให้โมเดลเขียนคำตอบ การประเมินว่าเอกสาร “เกี่ยวข้อง” ต้องแยกจาก “น่าเชื่อถือ” และ “ทันสมัย” เอกสารที่ตรงคำถามมากอาจมีข้อมูลผิดหรือล้าสมัยได้
อีกกรณีที่เห็นหน้าที่ชัดคือการดึงข้อมูลจากเอกสาร: ใช้ parser หาอีเมลหรือจำนวนเงินที่ปรากฏจริงก่อน แล้วให้ Jev เลือกว่า candidate ใดตรงบทบาทที่ต้องการ โค้ดคัดลอกค่าที่เลือกแทนการให้โมเดลพิมพ์ตัวเลขใหม่ วิธีนี้มีตัวอย่างใน Pre-parsed value extraction ของผู้พัฒนา ข้อจำกัดคือหากขั้นหา candidate พลาดค่าที่ถูกต้อง ขั้นเลือกก็ไม่สามารถกู้ค่าที่ไม่มีอยู่ในรายการได้
อ่าน benchmark และคำนวณต้นทุนอย่างไร
TypeSafe โฆษณาผลเร็วขึ้น 193.6 เท่าและถูกลง 444.6 เท่าจาก workflow evals พร้อมระบุในประกาศว่าตัวเลขนี้น่าจะอยู่ฝั่งสูงของประโยชน์ที่พบจริง ส่วนช่วงเวลา 70–500 มิลลิวินาทีเป็นข้อมูลที่ผู้พัฒนารายงาน โดยการทดสอบความเร็วที่เผยแพร่โดยทั่วไปทำจากฝั่งตะวันตกของสหรัฐฯ จึงไม่ควรนำมาเป็นคำรับประกันเวลาให้ผู้ใช้ในไทย ดู ผลและข้อจำกัดในประกาศเปิดตัว
หน้า Workflow evals อธิบายว่าประเมินสี่ workflow โดยให้โค้ดรับผิดชอบกฎและให้โมเดลตอบคำถามย่อย ค่าอ้างอิงมาจากคำตอบรวมของโมเดลขนาดใหญ่ ไม่ใช่ข้อเท็จจริงที่มนุษย์ตรวจทุกกรณี ข้อสรุปที่เหมาะสมจึงเป็นความสามารถในการทำงานตาม workflow และความสอดคล้องกับค่าอ้างอิงภายใต้เงื่อนไขนั้น การทำตามค่าอ้างอิงได้ดีไม่รับประกันว่าจะตรงคำตัดสินของผู้เชี่ยวชาญในโดเมนของเรา
ราคา ณ วันที่ตรวจเอกสาร: หน้า Models ระบุ $0.042 ต่อหนึ่งล้าน input tokens และไม่คิดค่า output tokens ตัวอย่างคำนวณสมมติ ถ้าหนึ่งล้านคำขอใช้ input เฉลี่ยคำขอละ 2,000 tokens รวม state และคำถาม จะเป็น 2,000 ล้าน tokens ค่าประมวลผลตามอัตรานี้เท่ากับ 2,000 × $0.042 = $84 ไม่ใช่ค่าใช้บริการหนึ่งล้านคำขอในราคา $0.042
ตัวเลข $84 นี้ยังไม่รวม retry ค่าโครงสร้างพื้นฐาน ค่าบริการผ่านผู้ให้บริการอื่น ภาษี การแปลงสกุลเงิน หรือการตรวจโดยคน และยังต้องทดสอบจำนวน tokens ของข้อความไทยจริง หากต้องลดข้อมูลก่อนส่ง ควรคำนวณต้นทุนขั้นเตรียมข้อมูลด้วย
วิธีเปรียบเทียบที่ KrobClick เสนอคือให้ Jev, กฎหรือ classifier เดิม และ LLM ที่รองรับ structured outputs ทำงานเดียวกันด้วยข้อมูลและนิยามคำตอบเดียวกัน วัดทั้งอัตราผิด เวลาเฉลี่ย เวลา p95 หรือเวลาที่ 95% ของคำขอเสร็จภายใน และต้นทุนรวมต่อกรณีที่จบงานได้ถูกต้อง การตัดสินใจที่ถูกลงต่อครั้งแต่ส่งเรื่องให้คนตรวจมากขึ้นอาจไม่ประหยัดทั้งระบบ
ข้อจำกัดของ Jev 1.13 ที่ต้องออกแบบรับมือ
TypeSafe มีหน้า Jev 1.13 jaggedness ซึ่งทบทวนวันที่ 2 ตุลาคม 2569 ระบุปัญหาทั้งคณิตศาสตร์ การเทียบวันเวลา การตีความตรงตัว ข้อมูลที่ไม่เกี่ยวข้องมากเกินไป เนื้อหาจงใจชักนำ และลำดับตัวเลือกที่อาจกระทบคำตอบ นี่เป็นข้อมูลสำคัญกว่าการอ่านคำว่า “ไม่ hallucinate” เพียงประโยคเดียว
- การนับและคำนวณ: ให้โค้ดนับจำนวนรายการ คิดดอกเบี้ย และตรวจช่วงตัวเลข ใช้โมเดลเฉพาะการตัดสินเชิงความหมายที่โค้ดนิยามได้ยาก
- วันเวลา: แยกการอ่านเจตนาหรือส่วนประกอบวันที่ออกจากการเปรียบเทียบช่วงเวลา และให้โค้ดจัดการปฏิทิน เขตเวลา และ พ.ศ./ค.ศ.
- บริบทมากเกินไป: ความจุ context ไม่ใช่คำรับประกันความแม่นยำ กรองสิ่งที่ไม่เกี่ยวข้องก่อนส่ง
- ข้อความชักนำ: ทดสอบกรณีที่เนื้อหาสั่งให้ละเลยเกณฑ์หรือประกาศเองว่าต้องถูกจัดเป็นหมวดใด อย่าให้คำตอบข้ามการตรวจสิทธิ์
- ความไวต่อการจัดตัวเลือก: สลับลำดับ candidate และตรวจว่าคำตอบยังคงเสถียรกับตัวอย่างเดิม
การรับประกันว่าคำตอบเป็นสมาชิกของชุดที่อนุญาตช่วยป้องกันการสร้างชื่อหมวดที่ไม่มีอยู่ แต่ ยังเลือกสมาชิกผิดได้ ตัวอย่างสมมติ “อนุมัติ” เป็นคำตอบที่ผ่าน schema แต่การอนุมัติผิดคนยังเป็นความผิดพลาดทางธุรกิจ จึงต้องวัดความถูกต้องเชิงความหมายแยกจากอัตราที่รูปแบบคำตอบผ่าน
ตามหน้า Models รุ่นที่ตรวจรับข้อความ ไม่รับภาพ เสียง หรือวิดีโอโดยตรง และกำหนดงบรวมคำขอ 64k tokens พร้อมเงื่อนไข state บวกคำถามที่ยาวที่สุดไม่เกิน 32k tokens ดู ขีดจำกัดรุ่นปัจจุบัน งานอ่านภาพจึงต้องมีขั้นแปลงเป็นข้อความหรือข้อมูลก่อน ซึ่งอาจสร้างความผิดพลาดเพิ่มขึ้นตั้งแต่ต้นทาง
ขีดจำกัด 64k ต่อคำขอและ 32k สำหรับ state รวมคำถามหนึ่งข้อเป็นค่าเริ่มต้นของทั้ง 1.13 และ 1.14 เอกสารมีโหมด long context แบบเปิดเพิ่มด้วย header ซึ่งขยายทั้งสองเพดานเป็น 262k tokens แต่การรับบริบทมากขึ้นไม่ยืนยันความแม่นยำ จึงควรเริ่มจากค่าเริ่มต้นและตรวจจำนวน tokens ของคำขอจริงก่อนพิจารณาโหมดนี้
แผนทดสอบกับข้อมูลภาษาไทย
TypeSafe ระบุว่าภาษาอังกฤษเป็นภาษาหลักในการฝึกและให้ความแม่นยำดีที่สุดในปัจจุบัน ภาษาอื่นรับได้แต่คุณภาพไม่เท่ากัน ดู Language support เราจึงยังสรุปไม่ได้ว่า Jev แม่นสำหรับภาษาไทยเพียงเพราะส่งข้อความไทยแล้ว API รับคำขอได้
แผนต่อไปนี้เป็นข้อเสนอของ KrobClick ไม่ใช่ผล benchmark ที่เรารันแล้ว เริ่มจากงานที่ความผิดพลาดแก้คืนได้ เช่น แนะนำหมวดคู่มือ ก่อนขยายไปยังงานที่กระทบผู้ใช้มากขึ้น
- นิยามคำตอบก่อนเลือกโมเดล: เขียนตัวอย่างเข้าหมวด ไม่เข้าหมวด และข้อมูลไม่พอ ให้ผู้ตรวจเข้าใจตรงกัน กรณีกำกวมควรมีแนวทางยกระดับให้คนตรวจ
- สร้างชุดตัวอย่างที่สะท้อนการใช้งาน: รวมภาษาไทยทางการ ภาษาพูด คำตกหล่น ไทยปนอังกฤษ คำปฏิเสธ และหลายความต้องการในข้อความเดียว ใช้ข้อมูลสังเคราะห์หรือข้อมูลที่ลบรายละเอียดส่วนตัวแล้ว
- แยกชุดปรับคำถามออกจากชุดตัดสินผล: ใช้ส่วนแรกเลือกเกณฑ์และ threshold แล้วตรึงค่าก่อนประเมินอีกชุด หลีกเลี่ยงการปรับ prompt ไปเรื่อย ๆ จนจำคำตอบชุดทดสอบ
- วัดผลรายหมวด: ตรวจ precision ว่าที่จัดเข้าหมวดนั้นถูกกี่ส่วน และ recall ว่าจับกรณีที่ควรอยู่ในหมวดได้ครบแค่ไหน พร้อมนับกรณีที่ต้องให้คนตรวจ อย่าอ่าน accuracy รวมเพียงค่าเดียวเมื่อบางหมวดพบน้อย
- ตรวจความน่าจะเป็น: แบ่งคำตอบตามช่วง probability แล้วเทียบกับสัดส่วนผลจริงในแต่ละช่วง แสดงจำนวนตัวอย่างด้วย กลุ่มที่มีข้อมูลน้อยยังประเมินการปรับเทียบได้ไม่มั่นคง และต้องแยกการตรวจนี้จากค่า confidence
- วัดหลังตั้งเกณฑ์ส่งให้คนตรวจ: รายงานทั้งอัตรางานที่ระบบทำเองและอัตราผิดในงานส่วนนั้น ระบบที่ดูแม่นเพราะส่งเกือบทั้งหมดให้คนไม่ได้มีประโยชน์เท่าระบบที่ทำเองได้มากในระดับความเสี่ยงเดียวกัน
- ทดสอบเงื่อนไขให้ล้มเหลว: สลับลำดับตัวเลือก เพิ่มข้อความไม่เกี่ยวข้อง ใส่ข้อความชักนำ และจำลอง timeout หรือบริการไม่พร้อม ให้เส้นทางสำรองทำงานได้จริง
ตัวอย่างสมมติที่ควรอยู่ในชุดทดสอบคือ “ไม่ได้อยากแปลง PDF แค่อยากย่อรูปที่อยู่ในไฟล์” และ “ไม่ต้องสร้าง QR ช่วยอ่านอันเดิมให้หน่อย” สองข้อความนี้มีคำของหลายหมวด แต่เจตนาไม่เท่ากับการจับคีย์เวิร์ด อีกกลุ่มคือ “ไฟล์ใหญ่ส่งไม่ได้” ที่ยังไม่บอกชนิดไฟล์ ระบบที่ถามเพิ่มได้อาจเหมาะสมกว่าระบบที่เลือกหมวดอย่างมั่นใจ
ข้อมูลส่วนตัวและการนำขึ้นใช้งาน
การใช้ Jev ผ่าน API ต้องส่ง state ออกจากระบบของผู้เรียกไปยังผู้ให้บริการ นโยบายของ TypeSafe ระบุว่าจะไม่ใช้ Input ฝึกหรือ fine-tune โมเดล แต่นั่นไม่ใช่ข้อความเดียวกับ “ไม่เก็บข้อมูลเลย” เอกสาร Legal แยกข้อเสนอ zero data retention สำหรับลูกค้า enterprise ไว้ต่างหาก ดู Privacy Policy และ Legal และ ZDR ควรตรวจเงื่อนไขสัญญาที่ใช้กับบัญชีจริงก่อนส่งข้อมูลลูกค้า
บทความนี้ไม่ได้เพิ่มการเรียก Jev ให้ KrobClick สำหรับเว็บที่ออกแบบให้ไฟล์อยู่ในเบราว์เซอร์ การเพิ่มบริการตัดสินใจภายนอกเป็นการเปลี่ยนเส้นทางข้อมูลที่ต้องพิจารณาแยกจากการเขียนบทความ ไม่ควรส่งไฟล์ เอกสาร หรือประวัติผู้ใช้ไป API เพียงเพราะอยากทดลองโมเดล
หากนำไปทำระบบภายนอก ข้อเสนอของ KrobClick คือให้เรียกบริการผ่านส่วนที่เก็บ API key ได้อย่างปลอดภัย จำกัดข้อมูลที่ส่ง ตรวจสิทธิ์ก่อนลงมือ และเตรียมเส้นทางสำรองเมื่อบริการใช้ไม่ได้ เก็บบันทึกผลเท่าที่จำเป็นต่อการตรวจคุณภาพโดยไม่บันทึกความลับหรือข้อมูลส่วนตัวเกินจำเป็น
ด้านความทำซ้ำได้ หน้า Models ระบุว่า alias อย่าง jev-latest เปลี่ยนรุ่นตามการออก release และคำตอบมีชื่อรุ่นจริงกลับมา ถ้า threshold ถูกปรับกับรุ่นหนึ่งแล้ว ควรตรึงรุ่นและทดสอบซ้ำก่อนอัปเกรด ดู Aliases และ versioned model IDs ส่วนการทำ shadow mode ซึ่งให้โมเดลตอบโดยยังไม่ใช้สั่งงานจริง เป็นวิธีที่ KrobClick เสนอให้ตรวจความคลาดเคลื่อนก่อนเพิ่มสิทธิ์อัตโนมัติ
เกณฑ์ตัดสินใจว่าเมื่อไรควรเลือก Jev
| ลักษณะงาน | วิธีที่ควรเริ่มประเมิน | เหตุผล |
|---|---|---|
| คำนวณยอดเงิน นับไฟล์ เทียบวันที่ | โค้ดและไลบรารีที่ตรวจสอบได้ | นิยามคำตอบแน่นอนและทดสอบขอบเขตได้ตรง |
| งานจำแนกคงที่ มีข้อมูลติดป้ายจำนวนมาก | กฎหรือ classifier เดิมเป็น baseline | อาจเหมาะกับต้นทุน ความเป็นส่วนตัว และข้อกำหนดเฉพาะงานอยู่แล้ว |
| ตัดสินจากความหมาย มีตัวเลือกชัด และเรียกบ่อย | ทดลอง Jev เทียบ baseline | ตรงกับสัญญาคำตอบและการประเมินคำถามย่อยของโมเดล |
| เขียนบทความ อธิบายเหตุผล สร้างโค้ดหรือแผนยาว | โมเดลสร้างข้อความ พร้อมการตรวจผล | ต้องการคำตอบแบบเปิด ไม่ได้มีชุดตัวเลือกครบล่วงหน้า |
| การกระทำที่กระทบเงิน สิทธิ์ หรือข้อมูลสำคัญ | workflow ที่ตรวจสิทธิ์และมีการยืนยันตามความเสี่ยง | คำตัดสินจากโมเดลอย่างเดียวไม่เพียงพอต่อการอนุมัติ |
ตารางนี้เป็นกรอบวิเคราะห์ของ KrobClick ความต่างที่น่าสนใจของ Jev คือการทำให้คำถามเชิงความหมายมีอินเทอร์เฟซคล้ายส่วนประกอบซอฟต์แวร์: ชุดคำตอบชัด มีการกระจายความน่าจะเป็น และนำมาประกอบเป็น workflow ได้ แต่ประโยชน์จริงต้องวัดจากข้อมูลของงานนั้น รวมค่าเตรียมข้อมูลและตรวจทานด้วย
สำหรับทีมที่กำลังทดลอง จุดเริ่มต้นที่ตรวจสอบง่ายคือเลือกการตัดสินใจหนึ่งเรื่อง สร้างชุดทดสอบไทยที่มีกรณีกำกวม วัดเทียบวิธีเดิม และเพิ่มทางออกเมื่อไม่แน่ใจ หาก Jev ลดเวลาและต้นทุนได้โดยยังรักษาอัตราผิดที่ยอมรับได้ จึงค่อยขยายขอบเขต ความเร็วของโมเดลเป็นประโยชน์เมื่อระบบรอบมันรู้ว่าควรเชื่อ ใช้ผล และหยุดตรงไหน
แหล่งอ้างอิง
- TypeSafe AI: Introduction
- TypeSafe AI: Introducing System One Models & Jev
- TypeSafe AI: AI primer และ RLCD
- TypeSafe AI: Choice
- TypeSafe AI: Score
- TypeSafe AI: Noul
- TypeSafe AI: Confidence และสูตรคำนวณ
- TypeSafe AI: HTTP API reference
- TypeSafe AI: Models ราคา ขีดจำกัด และภาษา
- TypeSafe AI: State
- TypeSafe AI: Speculative fan-out
- TypeSafe AI: Intent routing
- TypeSafe AI: Pre-parsed value extraction
- TypeSafe AI: Workflow evals และวิธีประเมิน
- TypeSafe AI: Jev 1.13 jaggedness
- TypeSafe AI: Legal และเงื่อนไข ZDR
- TypeSafe AI: Privacy Policy
- typesafe-ai/typesafe-sdk-python
ตรวจหน้า Models และขีดจำกัดเพิ่มเติมวันที่ 29 ตุลาคม 2569 โดยมี Jev 1.14 แล้ว ตัวอย่างคำขอยังคง pin Jev 1.13 และข้อจำกัด jaggedness เป็นของรุ่นนั้น บทความวิเคราะห์เอกสาร ไม่ได้เรียก API ตัวอย่างตัวเลขเป็นสมมติ ราคาและเงื่อนไขเปลี่ยนได้