
อ่านคะแนน Benchmark ของ AI อย่างไร ก่อนเลือกโมเดลให้เหมาะกับงาน
เห็น AI รุ่นหนึ่งได้ 90% แต่อีกรุ่นได้ 85% เราควรเลือกรุ่นที่คะแนนสูงกว่าทันทีหรือไม่? คำตอบขึ้นอยู่กับว่าข้อสอบวัดอะไร ใช้เงื่อนไขเดียวกันไหม และตรงกับงานภาษาไทยที่เราต้องทำแค่ไหน
คะแนน Benchmark ช่วยคัดตัวเลือก แต่ยังบอกไม่ได้ว่า AI จะทำงานของเราได้ดีแค่ไหน
เมื่อเห็นว่าโมเดล AI รุ่นหนึ่งได้คะแนน 90% และอีกรุ่นได้ 85% เราอาจอยากเลือกตัวเลขที่สูงกว่า แต่คำถามที่ต้องถามก่อนคือ คะแนนนั้นวัดงานอะไร ใช้วิธีทดสอบเดียวกันหรือไม่ และใกล้เคียงงานของเราหรือเปล่า Benchmark คือชุดโจทย์และวิธีให้คะแนนที่ออกแบบมาเพื่อประเมินความสามารถบางด้าน ไม่ใช่ใบรับรองว่าโมเดลจะตอบถูก 90% ในทุกสถานการณ์จริง
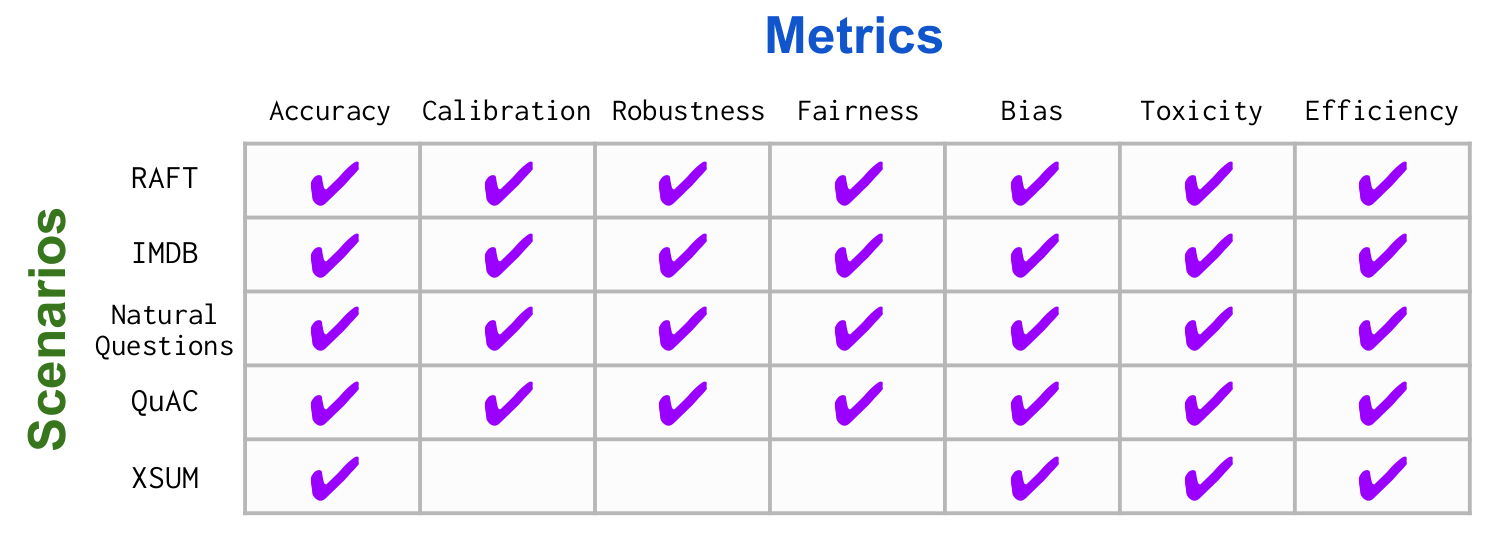
งานวิจัย HELM ของ Stanford เสนอให้ประเมินหลายสถานการณ์ หลายตัวชี้วัด และเปิดเผยสิ่งที่ยังไม่ได้วัด เพราะความแม่นยำอย่างเดียวไม่ครอบคลุมความทนทานต่อข้อมูลเปลี่ยน ความเป็นธรรม ความปลอดภัย หรือประสิทธิภาพ สำหรับผู้ใช้ทั่วไป แนวคิดนี้แปลเป็นกฎง่าย ๆ ว่า ใช้คะแนนเพื่อเลือกโมเดลที่น่าลอง แล้วใช้โจทย์จริงของตัวเองเพื่อตัดสินใจ
อ่านชื่อชุดทดสอบก่อนอ่านตัวเลข
ชื่อ Benchmark แต่ละชุดมีขอบเขตต่างกัน บางชุดเป็นข้อสอบความรู้แบบเลือกตอบ บางชุดวัดการแก้โจทย์เขียนโปรแกรม และบางชุดทดสอบการทำตามคำสั่ง หากงานของเราคือสรุปรายงานภาษาไทย คะแนนข้อสอบความรู้ภาษาอังกฤษอาจให้เบาะแสเรื่องความสามารถทั่วไป แต่ยังไม่ตอบว่าระบบจะสรุปตัวเลขไทยได้ถูกต้องหรือไม่
| สิ่งที่ชุดทดสอบเน้น | ตัวอย่าง | คำถามที่ยังต้องตรวจเอง |
|---|---|---|
| ความรู้และการให้เหตุผลผ่านคำถาม | MMLU และชุดข้อสอบลักษณะใกล้เคียง | เขียนอธิบายงานจริงได้หรือไม่ หรือเพียงเลือกคำตอบได้ถูก |
| เขียนโค้ดและผ่านกรณีทดสอบ | LiveCodeBench | อ่านโค้ดเดิม แก้บั๊ก และทำงานกับโครงการของเราได้ดีหรือไม่ |
| ประเมินหลายด้านและหลายบริบท | HELM | มีงานภาษาไทย ความเสี่ยง และต้นทุนที่เราสนใจรวมอยู่หรือไม่ |
ตัวอย่างเหล่านี้เป็นการอธิบายขอบเขต ไม่ใช่การจัดอันดับชุดทดสอบว่าอันไหนดีที่สุด รายละเอียดโจทย์ รุ่นข้อมูล และเกณฑ์วัดอาจเปลี่ยนตามเวอร์ชัน ดูคำอธิบายของผู้จัดทำก่อนใช้ผลคะแนนทุกครั้ง แหล่งอ้างอิง: Hugging Face Leaderboards และ LiveCodeBench
ทำไมคะแนนชื่อเดียวกันจึงเปรียบเทียบกันตรง ๆ ไม่ได้เสมอไป
วิธีส่งคำถามให้โมเดลมีผลต่อคะแนน เช่น ให้ตัวอย่างคำตอบล่วงหน้ากี่ข้อ (zero-shot หรือ few-shot) ให้โมเดลเลือกจากตัวเลือกหรือสร้างข้อความเอง ใช้การสุ่มคำตอบแบบใด และตัดสินว่าคำตอบถูกด้วยวิธีไหน แม้ใช้ชุดโจทย์ชื่อเดียวกัน คะแนนก็อาจต่างกันได้หากวิธีประเมินไม่เหมือนกัน
กรณีศึกษาที่ตรวจสอบได้คือ บทวิเคราะห์ MMLU ของ Hugging Face ที่เผยแพร่ 23 มิถุนายน 2023 ผู้เขียนเปรียบเทียบการประเมินชุดข้อมูลเดียวกันด้วยหลาย implementation แล้วพบว่าทั้งคะแนนและอันดับโมเดลอาจเปลี่ยนได้ บทเรียนนี้ยังใช้ได้ในเชิงวิธีคิด แม้ตัวเลขและรุ่นโมเดลในบทความต้นทางเป็นข้อมูลประวัติศาสตร์ ไม่ใช่อันดับปัจจุบัน
ก่อนเทียบสองคะแนน ให้ตรวจอย่างน้อยชื่อโมเดลและรุ่นที่ทดสอบ เวอร์ชันชุดโจทย์ จำนวนตัวอย่างประกอบคำถาม วิธีสุ่ม/ตั้งค่าการสร้างคำตอบ เกณฑ์ตัดสิน และวันที่ทดสอบ หากข้อมูลสำคัญเหล่านี้ขาดหาย ให้ถือว่าการเปรียบเทียบยังมีความไม่แน่นอนสูง
ระวังคะแนนสูงจากข้อสอบที่โมเดลอาจเคยเห็น
Data contamination หมายถึงกรณีข้อมูลทดสอบหรือเนื้อหาที่ใกล้เคียงรั่วเข้าไปอยู่ในข้อมูลฝึกหรือขั้นตอนปรับโมเดล ทำให้คะแนนอาจสะท้อนความคุ้นเคยกับโจทย์มากกว่าความสามารถแก้ปัญหาใหม่ ไม่ใช่ทุกคะแนนสูงจะเกิดจากปัญหานี้ แต่เป็นเหตุผลที่ควรอ่านวิธีแยกชุดฝึกกับชุดทดสอบ
โครงการ LiveCodeBench ใช้โจทย์เขียนโปรแกรมที่ทยอยเผยแพร่ตามช่วงเวลา และให้เลือกช่วงวันที่ของโจทย์ในการประเมิน เพื่อลดความเสี่ยงจากการใช้โจทย์เก่าที่อาจอยู่ในข้อมูลฝึก อย่างไรก็ดี การเลือกโจทย์ใหม่หรือการออกแบบชุดทดสอบเพื่อลด contamination ไม่ใช่หลักประกันว่าจะกำจัดความเสี่ยงนี้ได้หมด
ตัวอย่างสมมติ: โมเดลคะแนนสูงกว่าอาจไม่เหมาะกับงานที่ต้องทำ
สมมติทีมเล็ก ๆ ต้องใช้ AI อ่านอีเมลลูกค้าภาษาไทยและสรุปเป็นรายการงานที่ต้องติดตาม ทีมกำลังพิจารณาโมเดล A และ B ตัวเลขทั้งหมดในตารางต่อไปนี้ เป็นข้อมูลสมมติสำหรับสอนวิธีคิด ไม่ใช่ผลทดสอบของโมเดลจริง
| เกณฑ์ | โมเดล A (สมมติ) | โมเดล B (สมมติ) |
|---|---|---|
| คะแนน Benchmark ความรู้ทั่วไป | 90% | 85% |
| สรุปอีเมลภาษาไทยได้ครบตามเกณฑ์ 20 ตัวอย่าง | 15/20 = 75% | 18/20 = 90% |
| เวลาตอบเฉลี่ยต่อหนึ่งงานในเงื่อนไขทดสอบเดียวกัน | 12 วินาที | 7 วินาที |
| ค่าใช้จ่ายสมมติต่อ 100 งาน | 60 บาท | 40 บาท |
หากเป้าหมายคือสรุปอีเมลให้ครบและตอบเร็ว โมเดล B ดูเข้ากับงานตัวอย่างมากกว่า แม้คะแนนความรู้ทั่วไปต่ำกว่า แต่ชุดทดสอบเพียง 20 งานยังเล็กเกินกว่าจะสรุปคุณภาพในทุกสถานการณ์ได้ ควรเพิ่มจำนวนและความหลากหลายของตัวอย่าง รวมทั้งตรวจว่าคำตอบผิดแบบไหน การพลาดกำหนดส่งหรือชื่อผู้รับผิดชอบอาจสำคัญกว่าการใช้ถ้อยคำไม่สละสลวย
การคิดอัตราผ่านในตัวอย่างใช้สูตร จำนวนงานที่ผ่านเกณฑ์ ÷ จำนวนงานทั้งหมด × 100 ดังนั้น 15 ÷ 20 × 100 = 75% และ 18 ÷ 20 × 100 = 90% ส่วนค่าใช้จ่ายต้องกำหนดเงื่อนไขเดียวกัน เช่น ความยาวข้อความ การใช้เครื่องมือเสริม และจำนวนครั้งที่ลองใหม่ มิฉะนั้นเทียบราคาอย่างยุติธรรมไม่ได้
ทดลองประเมินงานของตัวเองแบบไม่ต้องเป็นนักวิจัย
กรอบต่อไปนี้เป็น ข้อเสนอเชิงปฏิบัติของ KrobClick ที่ประยุกต์จากหลักการวัดหลายมิติและประเมินในบริบทใช้งานจริงของ NIST AI Risk Management Framework ไม่ใช่มาตรฐานทดสอบที่ NIST กำหนดให้ทุกคนต้องใช้
- นิยามงานเดียวให้ชัด: เช่น สรุปข้อความลูกค้าเป็นหัวข้อ ปัญหา ผู้รับผิดชอบ และกำหนดส่ง โดยไม่เติมข้อมูลที่ต้นฉบับไม่มี
- ทำชุดตัวอย่างที่มีคำตอบอ้างอิง: เริ่มจากกรณีทั่วไปและกรณียาก เช่น ข้อความกำกวม วันที่หลายรูปแบบ ภาษาไทยปนอังกฤษ และข้อความที่ไม่มีข้อมูลพอให้สรุป ใช้ข้อมูลสมมติหรือข้อมูลที่ได้รับอนุญาตและลบข้อมูลระบุตัวบุคคลแล้ว
- ตั้งเกณฑ์ผ่านก่อนทดสอบ: ตรวจว่าข้อมูลสำคัญครบ ไม่มีชื่อหรือจำนวนเงินที่แต่งขึ้น และระบุว่าไม่ทราบเมื่อเอกสารไม่บอก อย่าเปลี่ยนเกณฑ์กลางทางเพียงเพื่อให้โมเดลที่ชอบชนะ
- ใช้เงื่อนไขเดียวกัน: คำสั่ง ชุดข้อมูล จำนวนครั้ง และข้อจำกัดเวลาต้องเทียบเคียงกัน หากโมเดลใดต้องตั้งค่าเฉพาะให้บันทึกความต่างไว้
- เก็บมากกว่าคะแนนรวม: จดข้อผิดพลาดสำคัญ เวลาตอบ ต้นทุนโดยประมาณ ความสม่ำเสมอ และความสะดวกในการตรวจแก้โดยคน
- ทบทวนก่อนใช้งานจริง: ให้คนตรวจผลลัพธ์ในงานที่มีผลกระทบ และทดสอบซ้ำเมื่อรุ่นโมเดล คำสั่ง หรือข้อมูลที่ใช้เปลี่ยนไป
สำหรับภาษาไทย ควรมีตัวอย่างที่สะท้อนภาษาที่ผู้ใช้จริงเขียน เช่น คำย่อ วันเดือนปี พ.ศ. การเว้นวรรค และชื่อเฉพาะ การทดสอบภาษาอังกฤษอย่างเดียวไม่เพียงพอจะยืนยันคุณภาพภาษาไทย หากงานเกี่ยวกับข้อมูลส่วนบุคคลหรือข้อมูลบริษัท ควรตรวจนโยบายการเก็บและใช้ข้อมูลของผู้ให้บริการก่อนส่งข้อมูลจริงเข้าสู่ระบบ
สิ่งที่ Benchmark ไม่ได้บอก และควรถามก่อนเลือกใช้
- ผลลัพธ์ในงานยาวหลายขั้น: คะแนนตอบคำถามครั้งเดียวไม่รับรองว่า AI จะทำงานหลายขั้นโดยไม่หลงประเด็น
- ความถูกต้องของคำตอบที่ไม่มีเฉลยตายตัว: งานเขียน วิเคราะห์ หรือสรุปต้องมีเกณฑ์คุณภาพและการตรวจของคนที่เหมาะสม
- ต้นทุนและความเร็วจริง: อาจขึ้นอยู่กับความยาวอินพุต การเรียกใช้เครื่องมือ ภาระระบบ และเงื่อนไขบริการในช่วงที่ใช้งาน
- ความปลอดภัยและความเป็นส่วนตัว: คะแนนความรู้สูงไม่ได้แปลว่าการจัดการข้อมูล การควบคุมสิทธิ์ หรือความเสี่ยงจากคำตอบผิดผ่านเกณฑ์ขององค์กร
- ความเปลี่ยนแปลงตามเวลา: รุ่นโมเดล ชุดทดสอบ และวิธีให้คะแนนอาจเปลี่ยน จึงต้องตรวจวันที่และเวอร์ชัน ไม่ยึดอันดับเก่าเป็นข้อสรุปปัจจุบัน
กรอบ NIST AI RMF เน้นให้การประเมินสอดคล้องกับบริบทการใช้งาน และติดตามความเสี่ยงทั้งก่อนและระหว่างใช้งานจริง นั่นทำให้คำถามว่า “เหมาะกับงานของเราหรือไม่” สำคัญไม่น้อยกว่าคำถามว่า “อันดับหนึ่งคือใคร”
เลือกจากหลักฐานสองชั้น: คะแนนสาธารณะและโจทย์จริงของเรา
ใช้คะแนน Benchmark สาธารณะคัดโมเดลที่น่าลอง แล้วอ่านวิธีทดสอบก่อนนำมาลองกับโจทย์ของตัวเองภายใต้เงื่อนไขเดียวกัน เปรียบเทียบความถูกต้อง ลักษณะข้อผิดพลาด ต้นทุน เวลา และข้อจำกัดด้านข้อมูล หากหลักฐานยังไม่พอก็ควรทดสอบต่อ ตารางอันดับเพียงตัวเดียวยังใช้ตัดสินว่า AI เหมาะกับงานไม่ได้
แหล่งข้อมูล
- Stanford CRFM: Language Models are Changing AI — The Need for Holistic Evaluation (2022)
- Hugging Face: What’s going on with the Open LLM Leaderboard? (2023)
- Hugging Face: Leaderboards and Evaluations documentation
- LiveCodeBench: Official repository and evaluation methodology
- NIST AI Risk Management Framework: Measure function
ตรวจเอกสารต้นทางวันที่ 12 ตุลาคม 2569 ตามเวลาไทย เนื้อหาเป็นคำอธิบายจากเอกสาร ไม่ใช่ผลทดลองใช้โมเดลของ KrobClick; ตัวเลข A/B เป็นสมมติทั้งหมด และไม่ได้ใช้เปรียบเทียบโมเดลจริง