
Zero-Trust AI Agent คืออะไร ทำไมต้องตรวจเจตนาก่อนเรียก Tool
คำสั่งเรียก API อาจถูกต้องทุกตัวอักษร แต่ยังเป็นการกระทำที่ผิดเจตนาของผู้ใช้ได้ นี่คือช่องว่างสำคัญของ AI Agent ที่มีสิทธิ์คืนเงิน แก้ฐานข้อมูล หรือส่งข้อมูล Zero-trust runtime พยายามตรวจมากกว่ารูปแบบคำสั่ง โดยมองทั้งเนื้อหา เจตนา และพฤติกรรมข้ามหลายรอบ
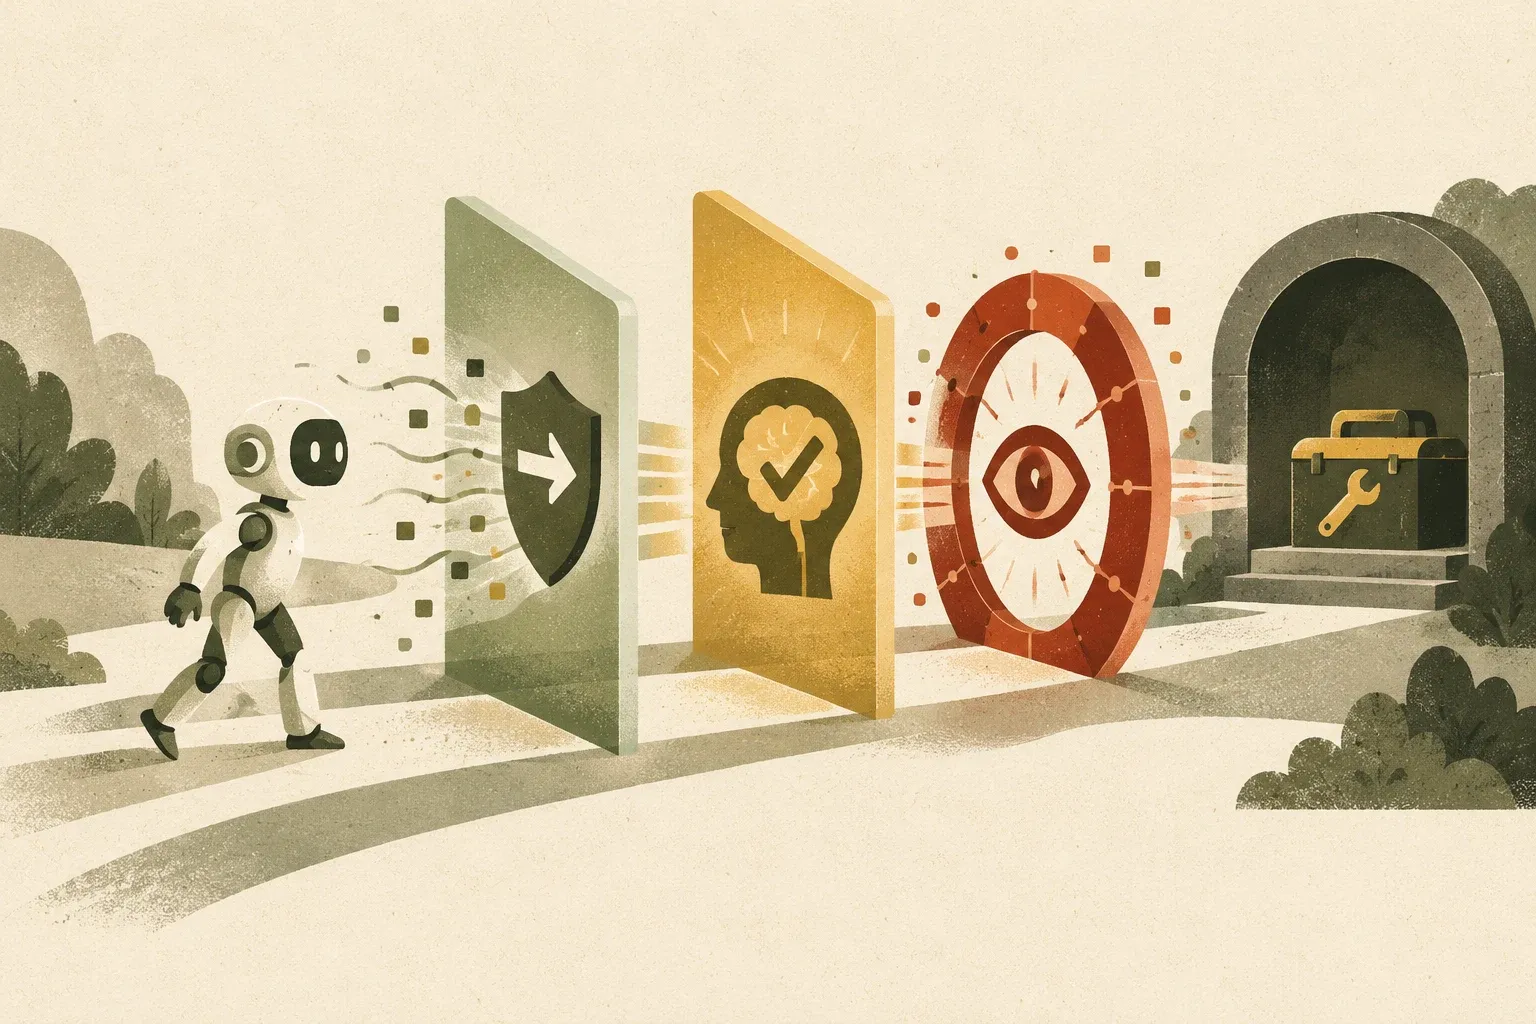
Zero-trust ตรวจสิทธิ์และบริบทของทุกการกระทำ
หลัก zero-trust คือไม่ให้สิทธิ์เพียงเพราะ request มาจากส่วนที่เคยเชื่อถือ แต่ตรวจทุกการกระทำตามบริบทและสิทธิ์ที่จำเป็น สำหรับ AI Agent ปัญหาซับซ้อนขึ้นเพราะโมเดลแปลภาษาธรรมชาติเป็น tool call คำสั่งที่มี schema ถูกต้องจึงอาจเกิดจากความเข้าใจผิด prompt injection หรือการหลอกให้ agent ทำสิ่งที่ผู้ใช้ไม่ได้ตั้งใจ
ตัวอย่างเช่น parser ตรวจได้ว่าคำขอคืนเงินมีจำนวนและบัญชีครบ แต่ไม่รู้ว่าลูกค้าขอคืนสินค้าชิ้นใด หรือมีคนค่อย ๆ แบ่งคำขอหลายรอบเพื่อเลี่ยงเพดาน ระบบต้องดูความหมายและประวัติ ไม่ใช่ syntax อย่างเดียว
สามชั้นควบคุมทำหน้าที่ต่างกัน
- กรอง prompt และ response: ตรวจ prompt injection, jailbreak, URL อันตราย และข้อมูลอ่อนไหวก่อนเข้าสู่วงจร agent
- นโยบายเชิงความหมาย: ประเมิน tool call ที่เสนอเทียบกับเจตนาผู้ใช้และกฎธุรกิจ ก่อนอนุญาตให้ทำจริง
- ตรวจความผิดปกติ: ดู log และ telemetry ต่อเนื่องเพื่อหาพฤติกรรมที่แต่ละ request ดูปกติ แต่รวมกันแล้วผิดปกติ
Google ยก Model Armor, Semantic Governance Policies และ Agent Anomaly Detection เป็นตัวอย่างบริการในแต่ละชั้น แนวคิดสำคัญคือไม่มีชั้นเดียวที่เห็นทุกอย่าง ตัวกรอง payload ไม่เข้าใจกระบวนการธุรกิจทั้งหมด และ policy ต่อ request อาจไม่เห็นรูปแบบสะสมข้าม session
Policy ควรบังคับใช้นอกโค้ดที่ agent ควบคุม
หากกฎความปลอดภัยอยู่ใน prompt หรือ function เดียวกับที่ agent แก้ไขได้ ผู้โจมตีอาจหาทางข้ามกฎนั้น การวางจุดบังคับที่ gateway หรือ platform ช่วยแยกหน้าที่ระหว่างผู้พัฒนา agent กับผู้ดูแลความปลอดภัย และทำให้ policy ครอบคลุม agent หลายตัวได้
อย่างไรก็ตาม platform policy ก็ต้องมี version, review, test และ rollback เช่นเดียวกับโค้ด กฎภาษาธรรมชาติอาจตีความกว้างหรือแคบเกินไป จึงต้องทดสอบทั้งกรณีโจมตีและงานปกติที่ไม่ควรถูกบล็อก
Identity, sandbox และลายเซ็นยังจำเป็น
การตรวจเจตนาไม่ได้แทน controls แบบกำหนดแน่นอน Agent ควรมี identity ของตนเอง ใช้สิทธิ์ขั้นต่ำ ลงลายเซ็นหรือยืนยันตัวตนเมื่อเขียนข้อมูล และรันโค้ดที่สร้างขึ้นใน sandbox เพื่อจำกัดผลกระทบ กฎเชิงความหมายเสริมช่องว่างระหว่าง “คำสั่งถูกโครงสร้าง” กับ “คำสั่งนี้ควรเกิดขึ้นหรือไม่”
งานที่กระทบเงิน ข้อมูลส่วนบุคคล หรือระบบสำคัญยังควรมี human approval โดยแสดงรายละเอียดปลายทาง จำนวน และเหตุผลก่อนยืนยัน การมี AI ตรวจ AI ไม่ควรถูกใช้เป็นเหตุผลตัดคนออกจากทุกจุดตัดสินใจ
Anomaly detection ต้องระวังทั้ง false positive และข้อมูลใน log
ระบบตรวจความผิดปกติอาจช่วยเห็นรูปแบบ เช่น agent เรียกคืนเงินหลายครั้งหรือเข้าถึงข้อมูลผิดช่วงเวลา แต่ย่อมมีทั้งการเตือนเกินจริงและเหตุการณ์ที่หลุดรอด ทีมต้องกำหนดว่าระดับใดเพียงแจ้งเตือน ระดับใดลดสิทธิ์ และระดับใดหยุด session
Log สำหรับวิเคราะห์พฤติกรรมอาจมี prompt, tool arguments และข้อมูลลูกค้า จึงต้องกำหนดระยะเก็บ การปกปิดข้อมูล สิทธิ์เข้าถึง และที่ตั้งการประมวลผล ไม่ควรเพิ่มการมองเห็นด้านความปลอดภัยด้วยการสร้างแหล่งข้อมูลอ่อนไหวที่ไม่มีการคุ้มครอง
ตัวอย่างสมมติ: นโยบายจำกัดยอดคืนเงินรวมของงานหนึ่งไว้ 10,000 บาท แต่ Agent เสนอคืนครั้งละ 4,000 บาทสามครั้ง แต่ละคำขออาจผ่าน schema และต่ำกว่าเพดานรายครั้ง ทว่ายอดรวมคือ 12,000 บาท ระบบนอก Agent จึงต้องนับยอดสะสมและหยุดให้ตรวจเมื่อเกินนโยบาย ไม่ใช้คำอธิบายเจตนาจากโมเดลแทนยอดจริง ตัวเลขนี้เป็นตัวอย่างออกแบบการควบคุม ไม่ใช่ค่าเริ่มต้นหรือผลทดสอบผลิตภัณฑ์ใด
สำหรับการทดสอบระบบ KrobClick เสนอให้จำลอง policy service ใช้งานไม่ได้ ผลตรวจหมดอายุ และ agent เปลี่ยนจำนวนหรือผู้รับหลังอนุมัติ งานที่มีผลกระทบสูงควรหยุดรอตรวจเมื่อยืนยันสิทธิ์ไม่ได้ และต้องตรวจพารามิเตอร์ที่จะลงมือจริงอีกครั้ง ไม่ใช้ผลอนุมัติของคำขอเดิมครอบคำขอที่เปลี่ยนไป เกณฑ์นี้เป็นข้อเสนอออกแบบ ไม่ใช่ผลรับรองบริการ Google
เริ่มจากแผนที่การกระทำที่มีผลกระทบสูง
ก่อนซื้อหรือสร้างระบบตรวจใหม่ ควรทำรายการ tools และจัดระดับผลกระทบ ระบุว่าใครเป็นเจ้าของ policy จุดใดต้องยืนยัน และสัญญาณแบบใดบ่งชี้ความผิดปกติ จากนั้นทดสอบ scenario เช่น prompt injection การแบ่งธุรกรรมหลายรอบ การใช้ credential ผิด agent และการตอบสนองเมื่อระบบ policy ล่ม
Zero-trust AI Agent เป็นแนวทางออกแบบการควบคุมหลายชั้น โดยถือว่าโมเดล ข้อมูลนำเข้า และคำขอเรียกเครื่องมืออาจผิดพลาดได้ ระบบจึงควรตรวจพบความผิดปกติ จำกัดผลกระทบ และเก็บหลักฐานให้ตรวจย้อนหลังได้
แหล่งอ้างอิง
- Google Developers Blog: Build zero-trust AI agents that judge intent, not just syntax
- OWASP Cheat Sheets Series Team
บทความนี้อ้างอิงแนวทางและบริการของ Google Cloud ณ วันที่ 7 ตุลาคม 2569 ตัวอย่างเป็นสถาปัตยกรรมประกอบการอธิบาย ไม่ใช่หลักฐานว่าควบคุมความเสี่ยงได้ครบทุกระบบ ควรทำ threat modeling และทดสอบอิสระก่อนใช้งานจริง