
RAG กับ Fine-tuning ต่างกันอย่างไร เลือกใช้ AI กับเอกสารองค์กรให้ถูกโจทย์
อยากให้ AI ตอบจากคู่มือที่อัปเดตทุกสัปดาห์ แต่ก็อยากให้เขียนคำตอบรูปแบบเดียวกันทุกครั้ง ต้องฝึกโมเดลใหม่เลยไหม? RAG และ Fine-tuning ช่วยแก้คนละปัญหา บทความนี้ช่วยเลือกวิธีโดยดูชนิดงาน ข้อมูล ต้นทุน และวิธีประเมินผลจริง
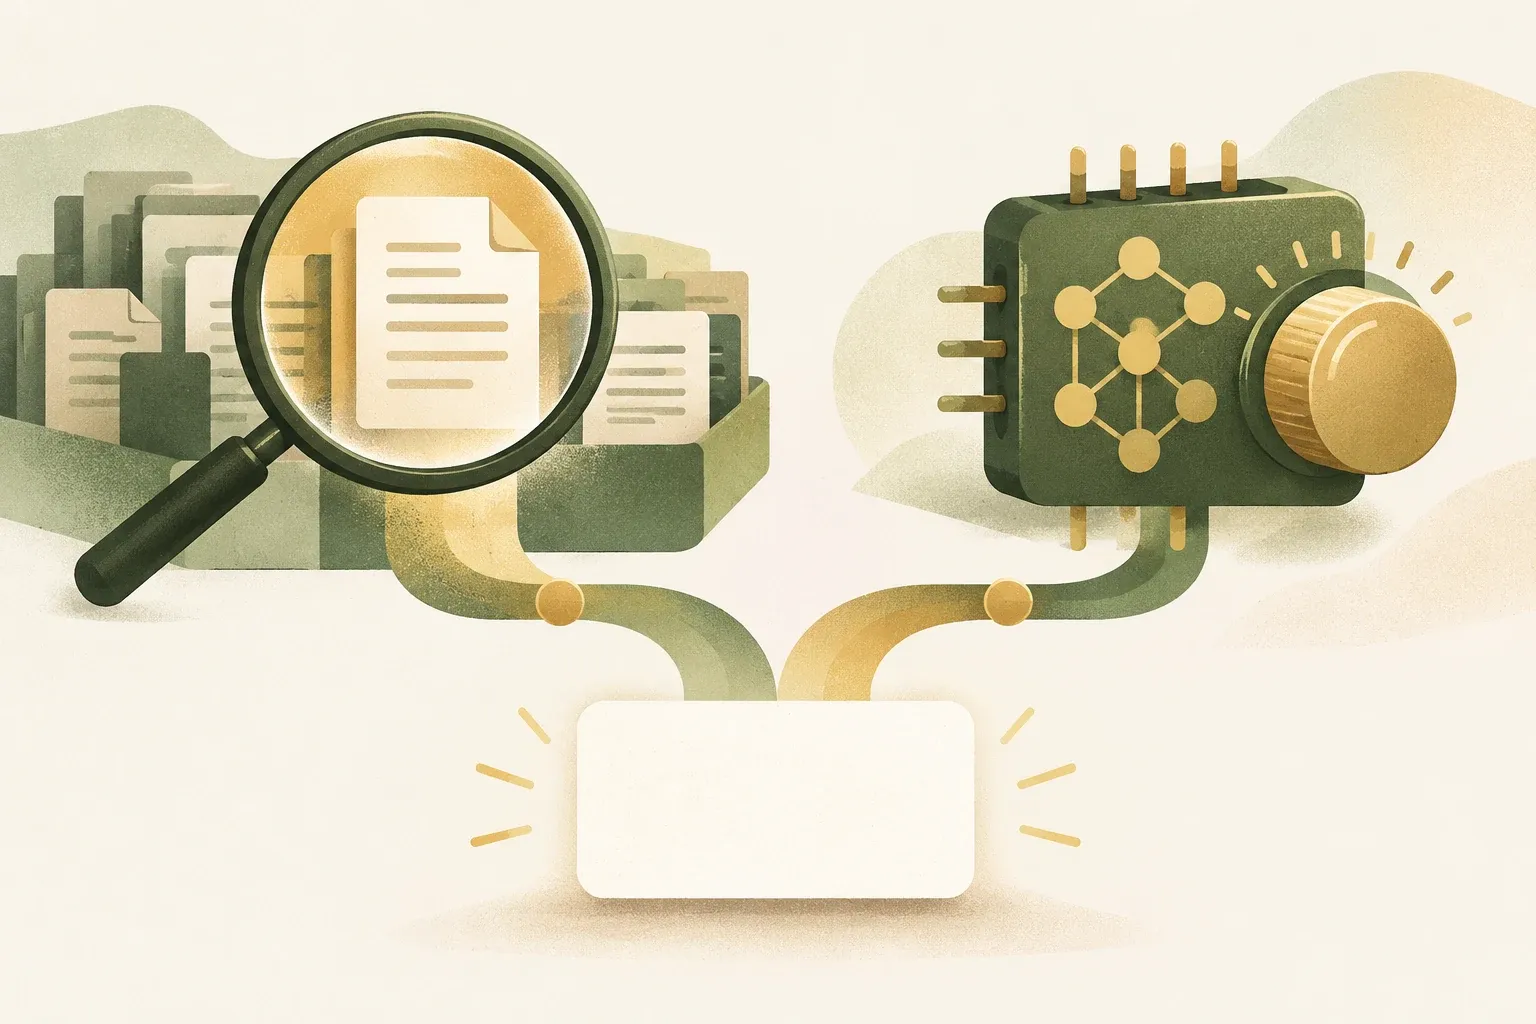
เลือกจากคำถามก่อน: ต้องการข้อมูลใหม่ หรือพฤติกรรมใหม่
หากปัญหาคือ AI ไม่มีข้อมูลเฉพาะที่อัปเดตอยู่เสมอ ให้พิจารณา RAG ก่อน แต่ถ้าข้อมูลมีอยู่ในพรอมป์ต์แล้วและต้องการให้โมเดลทำงานรูปแบบเดิมอย่างสม่ำเสมอ Fine-tuning อาจเหมาะกว่า ทั้งสองทางไม่ใช่คู่แข่งที่ต้องเลือกเพียงหนึ่ง และควรเริ่มจากการวัดคุณภาพของวิธีง่ายกว่าก่อนเสมอ
Microsoft Learn อธิบาย RAG ว่าเป็นการค้นคืนเนื้อหาที่เกี่ยวข้องแล้วส่งให้โมเดลใช้ประกอบคำตอบ ส่วน เอกสาร Fine-tuning ของ Microsoft อธิบายการฝึกเพิ่มเติมด้วยข้อมูลตัวอย่างเพื่อปรับพฤติกรรมหรือความสามารถเฉพาะงาน โดยไม่ได้ใช้แทนกลไกค้นข้อมูลปัจจุบัน
RAG ทำงานอย่างไร โดยไม่ต้องสอนโมเดลให้จำเอกสารทุกฉบับ
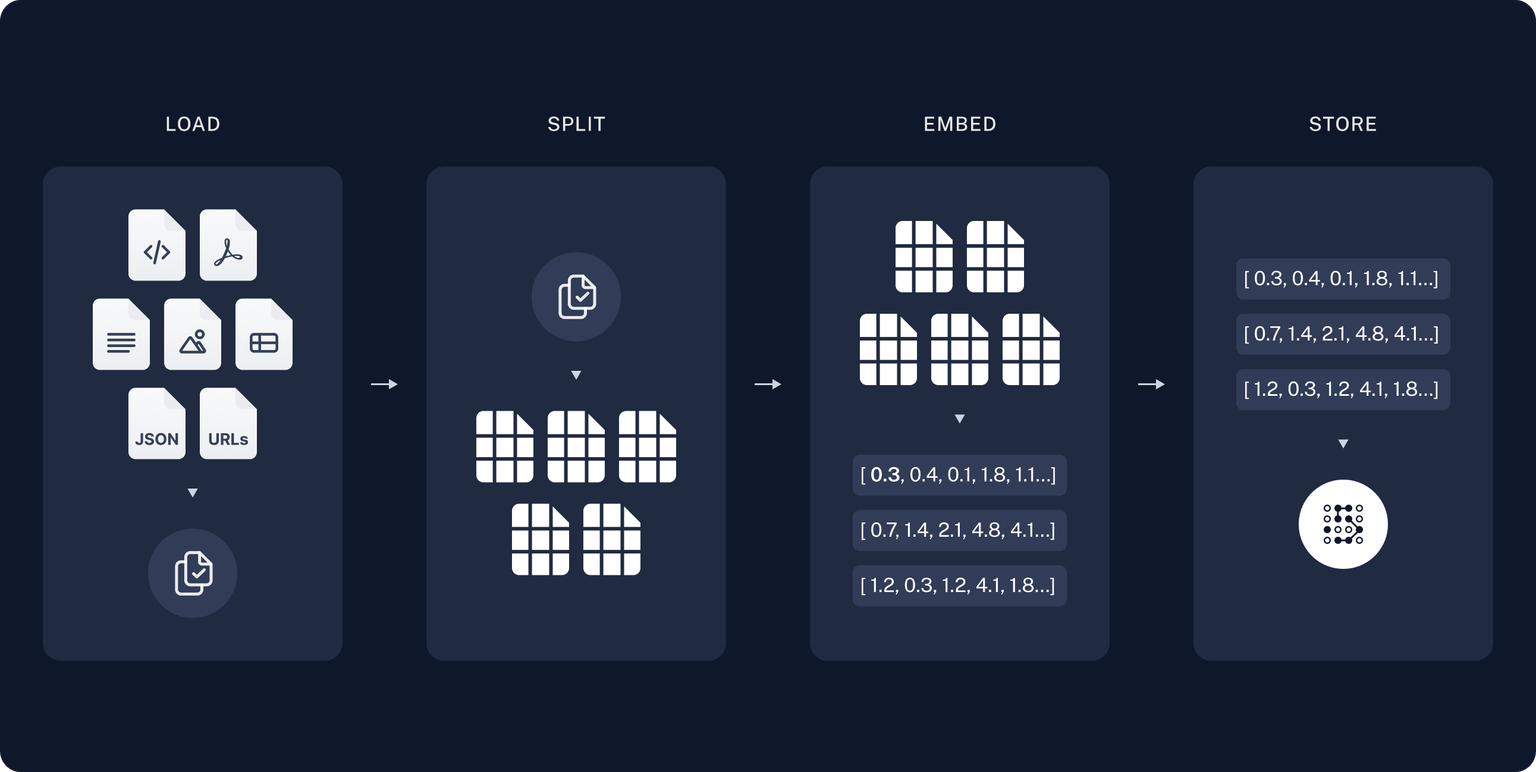
RAG ย่อจาก Retrieval-Augmented Generation หรือการสร้างคำตอบโดยมีข้อมูลค้นคืนประกอบ ลำดับทั่วไปคือจัดเอกสารให้ค้นได้ แบ่งเป็นส่วนที่เหมาะสม สร้างดัชนี แล้วเมื่อผู้ใช้ถาม ระบบค้นส่วนที่เกี่ยวข้องและส่งเป็นบริบทให้โมเดลสร้างคำตอบ สามขั้นตอนหลักคือ ค้นหา → เพิ่มบริบท → สร้างคำตอบ
ดัชนีอาจใช้การค้นด้วยคำสำคัญ เวกเตอร์ หรือทั้งสองแบบร่วมกัน แต่การค้นด้วยเวกเตอร์ก็อาจพลาดได้ หากไฟล์สแกนไม่มีข้อความ ตั้งสิทธิ์ค้นผิด หรือแบ่งตารางจนขาดบริบท คำตอบอาจผิดตั้งแต่ขั้นเตรียมข้อมูลก่อนส่งให้โมเดล
ตัวอย่างสมมติ: บริษัทมีคู่มือวันลาประจำปีฉบับเดือนมกราคมและฉบับปรับปรุงเดือนตุลาคม หากระบบชี้ไปยังฉบับที่อนุมัติล่าสุดพร้อมชื่อเอกสารและวันที่ ผู้ใช้มีโอกาสตรวจคำตอบย้อนกลับได้ดีกว่าการหวังให้โมเดลจำข้อกำหนดเดิมจากการฝึกครั้งก่อน แต่ถ้าค้นเจอผิดฉบับ AI ก็อาจตอบผิดอย่างมั่นใจได้เช่นกัน
Fine-tuning ปรับพฤติกรรมด้วยตัวอย่าง ไม่ใช่ฐานข้อมูลค้นหา
Fine-tuning คือการฝึกต่อจากโมเดลที่มีอยู่ โดยใช้ชุดข้อมูลตัวอย่างที่แสดงงานและผลลัพธ์ที่ต้องการ เพื่อช่วยให้โมเดลทำรูปแบบ น้ำเสียง หรือขั้นตอนที่มีแบบแผนได้สม่ำเสมอขึ้น วิธีนี้มีต้นทุนเตรียมข้อมูล ฝึก ประเมิน และดูแลรุ่นโมเดล และไม่รับประกันว่าความแม่นยำจะดีขึ้น
ตัวอย่างสมมติ: ทีมบริการลูกค้าต้องแปลงข้อความร้องเรียนภาษาไทยเป็น JSON ที่มีหมวดปัญหา ระดับความเร่งด่วน และคำตอบภาษาสุภาพเหมือนกันทุกครั้ง หากเริ่มจากคำสั่ง ตัวอย่างไม่กี่ชุด และการตรวจผลแล้วยังพลาดซ้ำในรูปแบบเดิม การประเมิน Fine-tuning บนชุดกรณีที่แยกจากชุดฝึกจึงอาจคุ้มค่ากว่าเพิ่มพรอมป์ต์ไปเรื่อย ๆ แต่ไม่ควรฝึกด้วยข้อมูลส่วนตัวโดยไม่มีสิทธิ์และมาตรการคุ้มครอง
เปรียบเทียบ RAG กับ Fine-tuning ในงานเดียวกัน
| ประเด็น | RAG | Fine-tuning |
|---|---|---|
| คำถามที่ตอบ | จะดึงข้อมูลต้นทางฉบับไหนมาใช้อย่างไร | จะทำให้โมเดลทำงานรูปแบบที่ต้องการอย่างไร |
| ข้อมูลเปลี่ยนบ่อย | อัปเดตชุดเอกสารและดัชนีได้ | ข้อมูลใหม่ไม่ปรากฏเอง ต้องวางแผนฝึกหรือค้นเพิ่ม |
| การตรวจย้อนกลับ | ออกแบบให้แสดงแหล่งที่ดึงมาได้ | น้ำหนักโมเดลไม่ใช่ลิงก์อ้างอิงเอกสาร |
| ต้นทุนหลัก | เตรียมเอกสาร ดัชนี การค้นและโทเค็นบริบท | ชุดข้อมูลฝึก การประเมิน ฝึกและให้บริการโมเดล |
| จุดเสี่ยง | ค้นผิดเอกสาร หลุดสิทธิ์ Prompt injection | ข้อมูลฝึกมีอคติ จำรูปแบบผิด และผลตกเมื่อโจทย์เปลี่ยน |
เริ่มจาก Prompt แล้วค่อยตัดสินใจลงทุนกับระบบใหญ่
- ระบุเกณฑ์สำเร็จ: ต้องตอบตามเอกสารฉบับล่าสุด หรือจำแนกข้อความให้ตรงแบบ? วัดความถูกต้องแบบใดและใครเป็นผู้อนุมัติ?
- สร้างชุดทดสอบภาษาไทยที่ไม่ใช้ฝึก: รวมคำถามง่าย ยาก กำกวม ถามข้ามเอกสาร และโจทย์ที่ควรตอบว่าไม่พบข้อมูล
- ลองวิธีพื้นฐาน: โมเดลเดิมกับคำสั่งชัดเจนและเอกสารอ้างอิงจำนวนน้อยเป็น Baseline ก่อนซื้อระบบค้นหาหรือฝึกโมเดล
- ถ้าข้อมูลไม่ทันสมัยหรือหาต้นฉบับไม่เจอ: ทดลองระบบค้นคืน ตรวจว่าชิ้นข้อมูลที่ดึงมาตรงข้อถามจริงหรือไม่
- ถ้ารู้ข้อมูลแต่จัดรูปแบบผิดซ้ำ: ปรับพรอมป์ต์หรือผลลัพธ์แบบมีข้อกำหนดก่อน แล้วจึงพิจารณา Fine-tuning
- ประเมินต้นทุนรวม: ดูค่าเตรียมข้อมูล ระบบค้น การฝึก ค่าประมวลผล เวลาแฝง และเวลาที่คนต้องแก้คำตอบ
ความปลอดภัยและข้อจำกัดที่ทั้งสองวิธีไม่แก้ให้เอง
RAG ไม่ได้ทำให้คำตอบจริงเสมอไป และเอกสารที่ค้นคืนอาจมีคำสั่งหลอกให้โมเดลทำสิ่งนอกงาน (Prompt injection) ระบบจึงต้องตรวจสิทธิ์เข้าถึงข้อมูลก่อนค้นและถือข้อความจากเอกสารเป็นข้อมูลที่ไม่เชื่อถือโดยอัตโนมัติ เช่นเดียวกัน Fine-tuning ไม่ใช่ระบบกำหนดสิทธิ์หรือเครื่องมือป้องกันข้อมูลรั่วไหล
หากทำงานกับไฟล์ลูกค้า สัญญา หรือข้อมูลบุคคล ต้องตรวจเงื่อนไขบริการ ขอบเขตการส่งข้อมูล และนโยบายการเก็บข้อมูลของผู้ให้บริการก่อน ไม่ควรนำไฟล์อ่อนไหวไปทดสอบบนระบบสาธารณะโดยไม่มีอนุญาต
เลือกวิธีที่ตรงจุดเสีย ก่อนเลือกระบบที่ซับซ้อน
สรุปเป็นคำถามเดียวได้ว่า “AI ตอบไม่ดีเพราะไม่มีหลักฐาน หรือเพราะทำงานผิดรูปแบบ?” หากไม่มีหลักฐาน ให้แก้การจัดเอกสารและการค้นคืนก่อน หากทำงานไม่ตรงรูปแบบ ให้เริ่มจากตัวอย่างและการประเมิน แล้วค่อยคิด Fine-tuning ถ้าต้องแก้ทั้งสองเรื่องก็อาจใช้ร่วมกัน แต่ต้องพิสูจน์กับโจทย์จริง ไม่ใช่เชื่อเพียงคำโฆษณา อ่านเพิ่มเติมเรื่อง วิธีใช้คะแนน Benchmark เป็นหลักฐานประกอบการเลือก AI ได้โดยไม่ใช้คะแนนสาธารณะแทนชุดทดสอบของตัวเอง
แหล่งข้อมูล
- Microsoft Learn: Retrieval augmented generation (RAG) and indexes
- Microsoft Learn: Fine-tuning in Microsoft Foundry
เรียบเรียงจากเอกสาร Microsoft Learn ที่ตรวจสอบในวันที่ 13 ตุลาคม 2569 ไม่มีการฝึกโมเดลหรือทดสอบระบบจริง ตัวอย่างบริษัทและผลลัพธ์เป็นสถานการณ์สมมติ ไม่ใช่คำรับรองประสิทธิภาพของผู้ให้บริการ