
RAG vs CAG vs KAG เลือกวิธีให้ AI ใช้ความรู้จากเอกสารอย่างไร
เมื่อ AI ต้องตอบจากข้อมูลองค์กร เราควรค้นเอกสารทุกครั้ง โหลดไว้ล่วงหน้า หรือจัดความรู้เป็นกราฟ? ทั้งสามแนวทางมีต้นทุนและจุดพลาดต่างกัน การเลือกจึงเริ่มจากลักษณะข้อมูลและคำถามที่ต้องตอบ
เลือก RAG, CAG หรือ KAG จากข้อมูลและหลักฐานที่ต้องใช้
RAG เหมาะให้เริ่มพิจารณาเมื่อจำเป็นต้องเลือกข้อมูลจากคลัง ส่วน CAG น่าทดลองเมื่อชุดความรู้คงที่และใส่ในบริบทได้ และ KAG น่าพิจารณาเมื่อคำถามต้องเชื่อมความสัมพันธ์หรือใช้กฎหลายขั้น KrobClick เสนอให้พิจารณาตามลักษณะงานเช่นนี้ โดยไม่ได้จัดอันดับว่าวิธีใดเก่งกว่ากัน ทั้งสามวิธีไม่ได้รับประกันว่าคำตอบจะถูกต้อง และระบบจริงสามารถผสมวิธีเหล่านี้ได้
หากยังไม่คุ้นกับการแบ่งเอกสาร สร้างดัชนี และค้นก่อนตอบ อ่าน RAG คืออะไร ทำไมให้ AI อ่านเอกสารแล้วก็ยังตอบผิดได้ ก่อน ส่วนความต่างระหว่างเพิ่มข้อมูลกับปรับพฤติกรรมโมเดลอยู่ใน RAG กับ Fine-tuning
| แนวทาง | เตรียมอะไร | เมื่อมีคำถาม | จุดที่ต้องจ่ายต้นทุน |
|---|---|---|---|
| RAG | เนื้อหาและดัชนีสำหรับค้น | ค้นหลักฐานที่เกี่ยวข้อง แล้วสร้างคำตอบ | คุณภาพการค้น การอัปเดตดัชนี และสิทธิ์เอกสาร |
| CAG ตามงาน Chan และคณะ | ชุดเอกสารในบริบทและ KV cache | ใช้สถานะที่เตรียมไว้ร่วมกับคำถาม | บริบทยาว หน่วยความจำ การสร้างและเปลี่ยนแคช |
| KAG ของ OpenSPG | กราฟความรู้ที่เชื่อมกับข้อความและดัชนี | วางแผน ค้น และแก้โจทย์ผ่านตัวดำเนินการหลายชนิด | นิยามความสัมพันธ์ สกัดข้อมูล และตรวจตรรกะ |
RAG: ค้นข้อมูลในรอบที่ถาม แต่ไม่จำเป็นต้องเป็นเวกเตอร์อย่างเดียว
Retrieval-Augmented Generation นำข้อมูลที่ค้นได้มาเสริมการสร้างคำตอบ ระบบที่พบบ่อยแบ่งเอกสารเป็นส่วน ทำ embedding แล้วค้นความคล้ายผ่านดัชนีเวกเตอร์ แต่การค้นด้วยคำตรงตัว วิธีผสม หรือการกรอง metadata ก็ใช้ได้ จึงไม่ควรนิยามว่า RAG ทุกระบบต้องมี vector database รูปแบบเดียว
RAG ช่วยให้เลือกส่งหลักฐานที่ค้นได้เข้าโมเดล โดยไม่ต้องใส่เอกสารทั้งคลังในทุกคำขอ แต่คำว่า “รองรับเอกสารจำนวนมาก” ยังต้องพิสูจน์ด้วยดัชนี โครงสร้างพื้นฐาน และภาระงานจริง เช่นเดียวกับคำว่า “ข้อมูลล่าสุด” ที่จะเป็นจริงก็ต่อเมื่อกระบวนการนำเข้าและลบเอกสารเก่าทำงานทัน หากคู่มือเปลี่ยนแต่ดัชนียังไม่เปลี่ยน ระบบก็ยังตอบจากฉบับเดิมได้
จุดตรวจสำคัญคือระบบค้นหลักฐานถูกชิ้นหรือไม่ และชิ้นนั้นมีเงื่อนไขครบหรือไม่ ความผิดพลาดอาจมาจากการค้น การแบ่งข้อความ หรือการสร้างคำตอบ ต้องแยกตรวจทีละขั้นก่อนสรุปว่าโมเดลไม่เก่งพอ
CAG: เตรียมสถานะการอ่านไว้ใช้ซ้ำ ไม่ได้ทำให้โมเดลจำถาวร
Cache-Augmented Generation ใน งาน Chan และคณะ เลือกชุดความรู้ที่จัดการได้และใส่ใน context window ได้ ให้โมเดลประมวลผลล่วงหน้า แล้วเก็บ KV cache ซึ่งเป็นสถานะระหว่างการคำนวณเพื่อใช้กับคำถามถัดไป วิธีนี้ตัดขั้นค้นเอกสารแบบทันทีออกจากเส้นทางตอบคำถาม แต่ไม่ได้เปลี่ยนน้ำหนักโมเดลให้จำข้อมูลถาวร
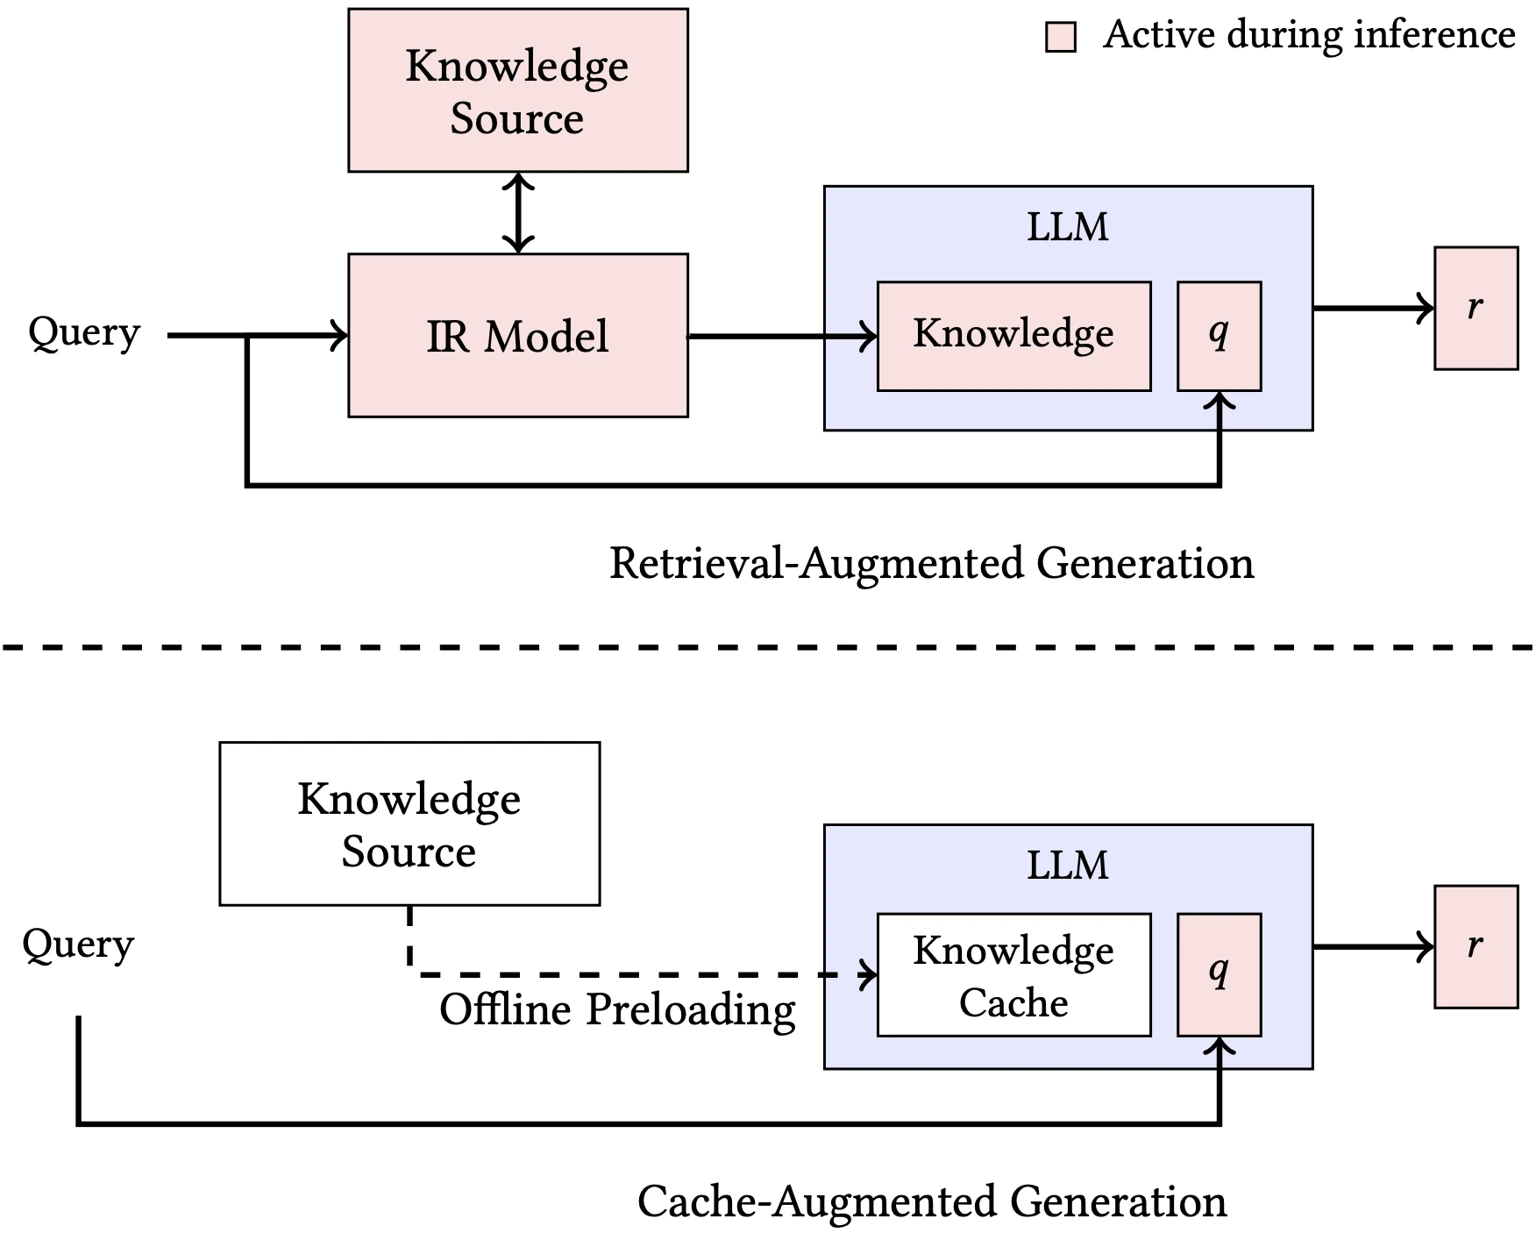
เมื่อไม่ค้น ก็ไม่มีความผิดพลาดจากการจัดอันดับผลค้นในรอบนั้น แต่ยังอาจอ่านบริบทผิด พลาดเงื่อนไข หรือตอบเกินข้อมูลได้ แม้เนื้อหาจะใส่ใน context window ได้ครบ โมเดลก็ยังอาจใช้ข้อมูลบางส่วนได้ไม่ดี ต้องเผื่อพื้นที่สำหรับคำถาม ประวัติ และคำตอบด้วย
การสร้างแคชรอบแรกยังใช้เวลาและทรัพยากร เมื่อเอกสารเปลี่ยน ต้องทำให้สถานะที่นำกลับมาใช้ตรงกับฉบับใหม่ และเมื่อผู้ใช้มีสิทธิ์ต่างกัน แคชต้องไม่รวมข้อมูลที่อีกคนไม่มีสิทธิ์เห็น คำว่า “ตอบเร็วมาก” จึงต้องวัดทั้งรอบเตรียม รอบนำกลับมาใช้ และรอบอัปเดต ไม่ดูเฉพาะกรณีที่แคชพร้อมแล้ว
งานวิจัยทดลองกับชุดข้อมูลและโมเดลที่กำหนด ไม่ได้พิสูจน์ว่าทุกระบบเอกสารควรเลิกใช้ RAG ส่วนบริการที่เรียกความสามารถว่า prompt caching อาจมีกติกาต่างจากโค้ด CAG ต้นฉบับ ต้องตรวจกลไกและข้อจำกัดของระบบที่จะใช้งานจริง
KAG: ใช้ความสัมพันธ์ร่วมกับการค้นข้อความและการคำนวณ
Knowledge Augmented Generation ของ OpenSPG เป็นกรอบที่เชื่อมกราฟความรู้กับข้อความต้นทาง แล้วใช้แผนการแก้โจทย์หรือ logical form กำกับการทำงาน แผนอาจเรียกการค้นข้อความ การค้นตามความสัมพันธ์ การให้เหตุผลเชิงภาษา และการคำนวณ จึงไม่ใช่เพียงเดินจากจุดหนึ่งไปอีกจุดหนึ่งในกราฟ และไม่ได้ตัดการค้นแบบเวกเตอร์ออกทั้งหมด
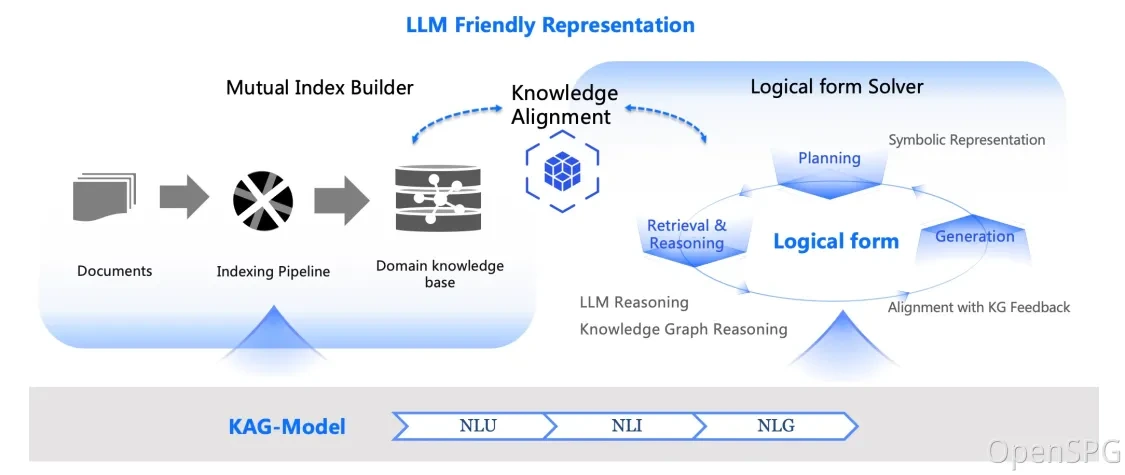
กราฟช่วยระบุว่าใครเกี่ยวข้องกับอะไรและสัมพันธ์อย่างไร เช่น ชื่อบริษัทเดียวกันอาจหมายถึงคนละนิติบุคคล หรือเงื่อนไขหนึ่งใช้เฉพาะช่วงเวลา การเชื่อมข้อมูลอย่างมีชนิดและหลักฐานช่วยให้ระบบตรวจเงื่อนไขเหล่านี้ได้เป็นขั้นตอน แต่หากสกัดชื่อผิด สลับความสัมพันธ์ หรือใช้กฎเก่า การให้เหตุผลที่ดูเป็นระบบก็ยังลงเอยด้วยคำตอบผิด
งานวิจัย KAG รายงานผลในชุดทดสอบและกรณีใช้งานเฉพาะ สิ่งนี้ยังไม่รองรับคำกล่าวว่าเป็นวิธีที่ดีที่สุดสำหรับการแพทย์ กฎหมาย หรือการเงินทุกกรณี การมีเส้นทางอ้างอิงให้ตรวจตามไม่ได้ยืนยันว่าข้อมูลและข้อสรุปถูกต้อง ผู้เชี่ยวชาญยังต้องตรวจแหล่งข้อมูล เวลาที่ใช้บังคับ และความเหมาะสมกับงานนั้น
โจทย์สมมติเดียวกัน ทำให้เห็นต้นทุนที่ต่างกัน
สมมติฝ่ายสนับสนุนมีคู่มือภาษาไทยและต้องตอบว่า “คำขอนี้ต้องใช้เอกสารอะไร ใครอนุมัติ และนโยบายฉบับไหนใช้บังคับ?” KrobClick ตั้งโจทย์นี้เป็นแบบฝึก โดยยังไม่ได้ทดลองสร้างระบบตามตัวอย่าง
- คู่มือสั้น คงที่ และทุกคนอ่านได้เท่ากัน: ลองส่งบริบททั้งหมดเป็นฐานก่อน แล้วประเมิน CAG ถ้ามีคำถามซ้ำและระบบรองรับการนำสถานะกลับมาใช้จริง
- คู่มือหลายแผนก อัปเดตบ่อย และสิทธิ์ต่างกัน: ลอง RAG ที่กรองแผนก วันที่ และสิทธิ์ก่อนค้น พร้อมตรวจว่าฉบับที่ยกเลิกถูกถอดออกแล้ว
- ต้องเชื่อมคำขอ หน่วยงาน ผู้อนุมัติ และเงื่อนไขตามวัน: พิจารณา KAG เมื่อมีเหตุผลให้ลงทุนจัดความสัมพันธ์ และมีผู้ตรวจว่ากราฟกับกฎตรงเอกสารจริง
องค์กรเดียวอาจใช้หลายวิธี เช่น ค้นคู่มือปัจจุบัน ใช้กราฟตรวจสายอนุมัติ และแคชคำสั่งส่วนคงที่ จึงเลือกใช้แต่ละวิธีกับส่วนงานที่เหมาะสมร่วมกันได้
วัดคุณภาพคำตอบและต้นทุนก่อนเลือกวิธีใช้จริง
เริ่มด้วยคำถามชุดเดียวและเฉลยที่คนตรวจแล้ว รวมกรณีตอบได้ ต้องเชื่อมหลายแหล่ง ไม่มีข้อมูล เอกสารขัดกัน และไม่มีสิทธิ์เข้าถึง ใช้โมเดลและเอกสารรุ่นเดียวกันเท่าที่ทำได้ บันทึกทั้งคำตอบ หลักฐาน รุ่นดัชนีหรือแคช และต้นทุนเตรียมระบบ เพื่อไม่ให้ความต่างของข้อมูลกลายเป็นคะแนนของสถาปัตยกรรม
- ตรวจข้อเท็จจริงในคำตอบเทียบต้นฉบับ โดยนับเงื่อนไขที่ตกหล่นและคำตอบเกินหลักฐานด้วย
- เปิดแหล่งอ้างอิงจริง แยก “มีลิงก์” ออกจาก “ลิงก์รองรับข้อกล่าวอ้างนั้น”
- วัดเวลาเตรียมข้อมูล เวลาเริ่มตอบ และเวลาจบคำตอบ แยกรอบแรกกับรอบใช้งานซ้ำ
- เปลี่ยนเอกสารหนึ่งฉบับแล้วตรวจว่าคำตอบใหม่ตามทัน รวมค่าใช้จ่ายและงานดูแลที่เกิดขึ้น
- ทดลองข้ามสิทธิ์และคำถามที่ไม่มีคำตอบ ระบบควรปฏิเสธหรือบอกข้อจำกัดโดยไม่เปิดเผยข้อมูลต้องห้าม
หากยังไม่รู้ว่าคำตอบผิดจากการค้น บริบท หรือความสัมพันธ์ ให้เก็บหลักฐานเพื่อแยกสาเหตุก่อนเพิ่มระบบที่ซับซ้อนขึ้น ตรวจว่าระบบใช้ข้อมูลถูกฉบับหรือไม่ อ้างย้อนกลับได้แค่ไหน และมีภาระดูแลที่เรารับได้หรือไม่
งานวิจัยและโครงการต้นทาง
- Lewis et al.: Retrieval-Augmented Generation
- Chan et al.: Don’t Do RAG — Cache-Augmented Generation
- CAG: โค้ดและแผนภาพต้นทาง
- Liang et al.: KAG — Knowledge Augmented Generation
- OpenSPG: KAG framework
ตรวจต้นทางวันที่ 18 ตุลาคม 2569 ตามเวลาไทย บทความนี้อธิบายจากงานวิจัยและเอกสาร ไม่ใช่ผล benchmark ของ KrobClick ตัวอย่างองค์กรเป็นสถานการณ์สมมติ คำว่า CAG และ KAG ในบทความยึดนิยามของงานวิจัยที่อ้าง ไม่ได้หมายถึงทุกผลิตภัณฑ์ที่ใช้ชื่อคล้ายกัน