
RAG คืออะไร ทำไมให้ AI อ่านเอกสารแล้วก็ยังตอบผิดได้
เราแนบคู่มือให้ AI แล้ว ทำไมยังตอบเรื่องเงื่อนไขผิด? การมีเอกสารอยู่ในระบบไม่ได้แปลว่าทุกส่วนถูกส่งให้โมเดลเห็น RAG ช่วยค้นส่วนที่เกี่ยวข้อง แต่ความผิดพลาดเกิดได้ทั้งตอนค้นและตอนตอบ
RAG คือการค้นข้อมูลมาเสริมคำตอบในรอบที่ถาม
Retrieval-Augmented Generation หรือ RAG คือแนวทางที่นำข้อมูลซึ่งค้นคืนได้มาเป็นบริบทให้โมเดลสร้างคำตอบ แทนการหวังพึ่งความรู้ที่อยู่ในน้ำหนักโมเดลเพียงอย่างเดียว งานวิจัย RAG ของ Lewis และคณะ เป็นแหล่งต้นทางสำคัญของแนวคิดนี้ ส่วนระบบจริงในปัจจุบันอาจใช้โครงสร้างและวิธีค้นต่างจากงานวิจัยต้นฉบับ
นึกถึงผู้ช่วยที่ได้รับคำถามเรื่องคู่มือบริการ เขาเปิดคลังเอกสาร หาหน้าซึ่งน่าจะเกี่ยวข้อง แล้วอ่านเพื่อเขียนคำตอบ หากเปิดผิดฉบับหรือได้เพียงข้อความครึ่งย่อหน้า ความสามารถในการเขียนที่ดีก็ไม่ทำให้หลักฐานที่ขาดหายกลับมาเอง
RAG ไม่เท่ากับการฝึกโมเดลใหม่ และไม่ใช่ชื่อเรียกรวมของการแนบไฟล์ทุกแบบ ระบบหนึ่งอาจส่งเอกสารทั้งฉบับเข้า context โดยไม่ค้น อีกระบบอาจค้นข้อความ บางระบบอาจอ่านภาพหน้าเอกสารด้วย การอธิบายระบบต้องดูเส้นทางข้อมูลจริง ไม่ตัดสินจากคำว่า “คุยกับ PDF” บนหน้าโฆษณา
RAG ค้นข้อความจากไฟล์แล้วส่งให้โมเดลอย่างไร
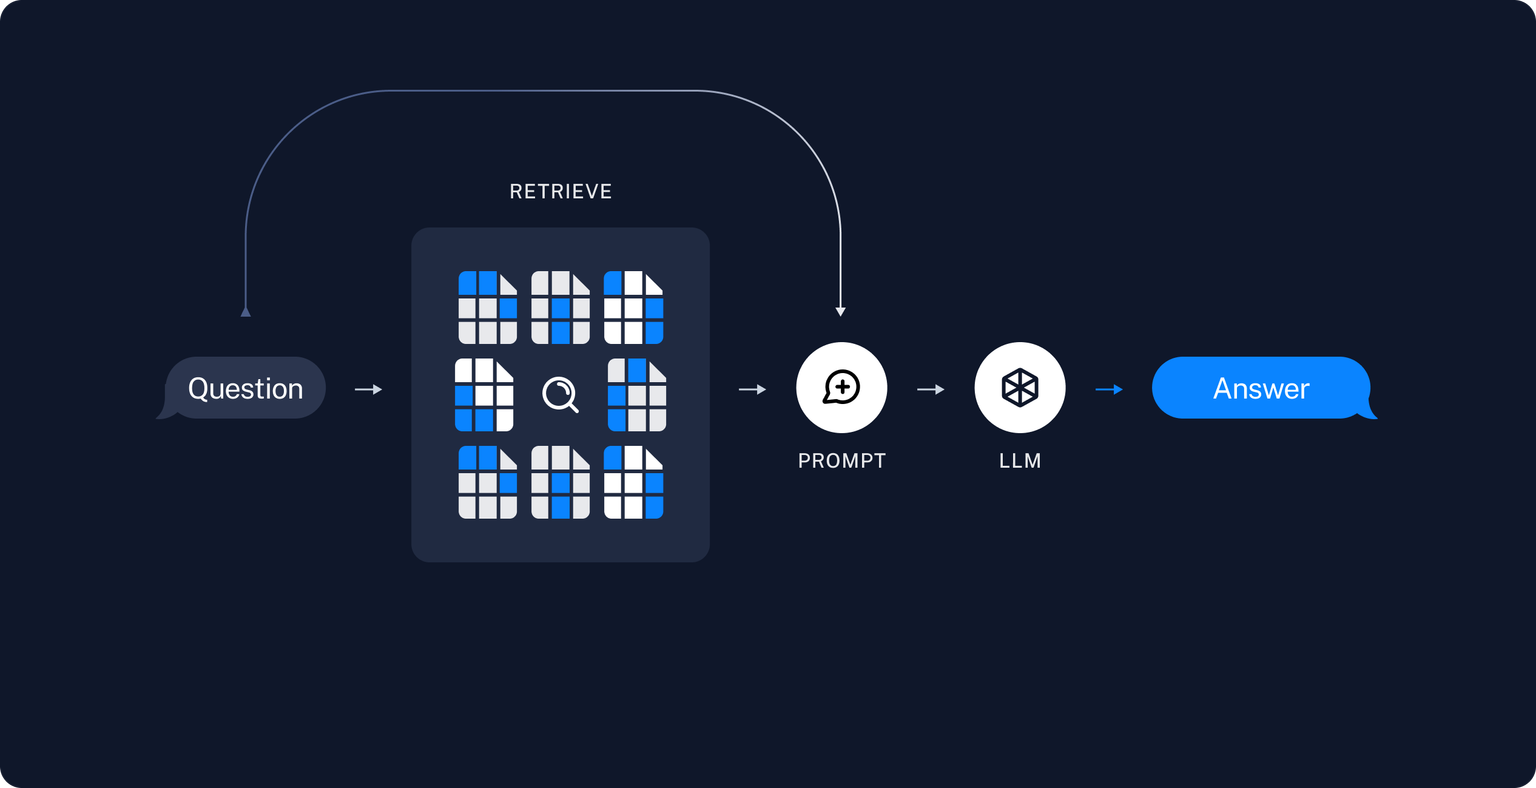
- เตรียมเนื้อหา: ดึงข้อความหรือข้อมูลจากเอกสาร พร้อมชื่อไฟล์ รุ่น วันที่ และสิทธิ์เข้าถึง
- แบ่งส่วน: แยกเป็นชิ้นข้อมูลที่ค้นได้ โดยพยายามคงหัวข้อและเงื่อนไขที่จำเป็น
- สร้างดัชนี: ทำโครงสร้างสำหรับค้นด้วยคำตรงตัว ความหมายผ่าน embedding หรือวิธีผสม
- ค้นเมื่อมีคำถาม: เลือกชิ้นข้อมูลที่เกี่ยวข้อง อาจกรองสิทธิ์ รุ่นเอกสาร และจัดอันดับใหม่
- สร้างคำตอบ: ส่งหลักฐานที่เลือกให้โมเดล พร้อมคำสั่งเรื่องขอบเขตและการอ้างอิง
- ตรวจผล: ตรวจว่าข้อกล่าวอ้างรองรับด้วยหลักฐานที่ระบบนำมาใช้จริง
Embedding คือการแทนข้อมูลด้วยชุดตัวเลขเพื่อช่วยค้นความสัมพันธ์ ไม่ใช่การแปลงเอกสารให้มีตรารับรองความจริง การค้นแบบคำตรงตัวอาจช่วยกับรหัสสินค้า ส่วนความคล้ายทางความหมายอาจช่วยกับคำถามที่ใช้คำต่างจากคู่มือ แต่ไม่มีวิธีใดควรถูกถือว่าถูกเสมอ
บทความ Contextual Retrieval ของ Anthropic อธิบายปัญหาของการแบ่งชิ้นที่ทำให้บริบทหาย และการผสมการค้นเชิงความหมายกับคำตรงตัว บทความของ KrobClick ใช้แนวคิดนี้เพื่อออกแบบคำถามตรวจระบบ โดยไม่ยกตัวเลขผลทดสอบของผู้พัฒนามารับประกันผลภาษาไทย
ตัวอย่างสมมติ: เงื่อนไขอยู่คนละส่วนกับคำตอบ
สมมติคู่มือร้านแห่งหนึ่งมีข้อความสองส่วน: “สินค้าสามารถคืนได้ภายใน 7 วันนับจากรับสินค้า” และหมายเหตุถัดมาว่า “ยกเว้นสินค้าสั่งทำตามขนาดเฉพาะบุคคล” ลูกค้าถามว่า “เสื้อสั่งตัดตามขนาดคืนได้ไหม” ข้อความและระยะเวลานี้เป็นข้อมูลสมมติเพื่ออธิบายระบบ ไม่ใช่เงื่อนไขร้าน KrobClick หรือคำอธิบายสิทธิ์ตามกฎหมาย
| สิ่งที่สังเกต | ชั้นที่ควรตรวจ | สิ่งที่ต้องแก้หรือทดสอบ |
|---|---|---|
| ค้นได้เฉพาะประโยคคืนได้ภายใน 7 วัน | การเตรียมข้อมูลและค้นคืน | หมายเหตุถูกนำเข้าหรือไม่ และเชื่อมกับหัวข้อเดียวกันได้ไหม |
| ค้นครบทั้งเงื่อนไขและข้อยกเว้น แต่ตอบว่าคืนได้ทุกกรณี | การสร้างคำตอบ | คำสั่งและความสามารถตีความข้อยกเว้นจากหลักฐาน |
| ตอบจากคู่มือเก่าที่มีเงื่อนไขต่างกัน | รุ่นและ metadata | กรองฉบับที่มีผลใช้และเอาสำเนาเก่าออกจากชุดตอบ |
| ตอบได้ถูกแต่เปิดเอกสารที่ผู้ถามไม่มีสิทธิ์ | การควบคุมสิทธิ์ | บังคับสิทธิ์ก่อนนำข้อมูลเข้าคำตอบ |
การเปลี่ยนไปใช้โมเดลที่ใหญ่ขึ้นอาจช่วยการตีความ แต่ไม่แก้กรณีเอกสารใหม่ไม่เคยถูกนำเข้า หรือสิทธิ์ค้นตั้งผิด การตรวจโดยดูทั้งคำตอบและข้อความที่ค้นได้ทำให้ลงทุนแก้ถูกชั้น
คำถามภาษาไทยต้องทดสอบด้วยคำที่คนใช้จริง
คู่มืออาจเขียนว่า “ยกเลิกคำสั่งซื้อ” แต่ผู้ใช้ถาม “เปลี่ยนใจไม่เอาของแล้วต้องทำไง” ควรมีทั้งคำถามภาษาทางการและภาษาพูดในชุดตรวจ อีกกลุ่มคือรหัส ตัวเลข และชื่อรุ่นที่ต่างกันเพียงตัวเดียว ซึ่งควรตรวจการจับคู่ตรงตัวแทนการถือว่าความหมายใกล้กันพอ
เตรียมคำถามที่มีคำตอบ คำถามที่ต้องอ่านข้อยกเว้น คำถามที่ไม่มีคำตอบ และคำถามที่เอกสารขัดกัน กำหนดหลักฐานที่ควรพบก่อนทดลองระบบ เพื่อไม่ให้คำตอบที่ฟังดูดีเปลี่ยนเกณฑ์ของเราไปตามผลที่ได้
หากทดสอบเพียงชุดเล็ก ให้รายงานจำนวนข้อและรายละเอียดความผิดพลาด ไม่เรียกอัตราผ่านจากตัวอย่างที่เลือกเองว่าเป็นความแม่นยำของงานทั้งหมด และควรตรวจซ้ำเมื่อเปลี่ยนโมเดล การแบ่งเอกสาร หรือคลังข้อมูล เพราะเงื่อนไขเหล่านี้เปลี่ยนพฤติกรรมได้
ประเมินการค้นกับคำตอบแยกกัน
- ชั้นค้น: มีหลักฐานที่จำเป็นอยู่ในผลค้นหรือไม่ เป็นฉบับที่ถูกและผู้ถามเข้าถึงได้หรือไม่
- ชั้นตอบ: ตอบตรงคำถาม ครบเงื่อนไข และไม่เติมสิ่งที่หลักฐานไม่มีหรือไม่
- ชั้นอ้างอิง: เปิดแหล่งได้ และข้อความที่อ้างรองรับข้อกล่าวอ้างจริงหรือไม่
- ชั้นปฏิเสธตอบ: เมื่อไม่พบหรือข้อมูลขัดกัน ระบบบอกข้อจำกัดและส่งให้คนตรวจได้หรือไม่
- ชั้นใช้งาน: เวลาและค่าใช้จ่ายรับได้กับงานจริงหรือไม่ โดยนับการค้นและการตรวจด้วย
แบบบันทึกง่าย ๆ คือ “คำถาม / เอกสารที่ควรพบ / เอกสารที่ค้นได้ / คำตอบ / จุดผิด / ผู้ตรวจ” หากยังเข้าถึงผลค้นไม่ได้ ให้ระบุข้อจำกัดนี้ไว้ ไม่สรุปสาเหตุจากคำตอบปลายทางอย่างเดียว
ใช้ RAG เมื่อมีเหตุผลด้านข้อมูล ไม่ใช่เพราะเป็นคำยอดนิยม
คลังเอกสารที่เปลี่ยนบ่อย ต้องตรวจอ้างอิง หรือมีหลายสิทธิ์เข้าถึงเป็นเหตุผลให้พิจารณาแนวทางค้นเสริม แต่เอกสารสั้นเพียงฉบับเดียวอาจเริ่มจากการส่งบริบทตรง ๆ ได้ ระบบที่ซับซ้อนขึ้นมีงานดูแลดัชนี รุ่นข้อมูล สิทธิ์ และการประเมินเพิ่มขึ้นด้วย
ก่อนเลือกเทคโนโลยี ให้ระบุว่าข้อมูลที่ถูกต้องอยู่ที่ไหนและจะตรวจอย่างไรว่าระบบใช้ข้อมูลนั้น คำตอบจะช่วยแยกว่าต้องแก้การค้น การจัดเอกสาร หรือการตรวจคำตอบ การเพิ่มความยาว Prompt เพียงอย่างเดียวอาจไม่แก้สาเหตุ
แหล่งข้อมูล
- Lewis et al.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Anthropic: Introducing Contextual Retrieval
ตรวจเอกสารต้นทางวันที่ 14 ตุลาคม 2569 ตามเวลาไทย ตัวอย่างและคำสั่งภาษาไทยเป็นข้อเสนอของ KrobClick ไม่ใช่ผลทดลองผลิตภัณฑ์ ความสามารถและการตั้งค่าอาจต่างตามรุ่นหรือบัญชี ควรตรวจต้นฉบับและผลลัพธ์ก่อนใช้งานจริง