
รัน AI Agent ในเครื่องด้วย Antigravity SDK ได้ประโยชน์อะไร
AI Agent ที่ช่วยอ่านและแก้โค้ดมักต้องเห็นข้อมูลละเอียดของโครงการ หากทุกขั้นตอนส่งขึ้นคลาวด์ ทีมอาจติดข้อจำกัดด้านความลับ ค่าใช้จ่าย หรือเครือข่าย Antigravity SDK ของ Google เพิ่มทางเลือกรัน agent ด้วยโมเดลในเครื่องและผสมงาน local กับ cloud ตามความเหมาะสม
Local AI Agent คืออะไร
Local AI Agent คือระบบที่ให้โมเดลและวงจรการทำงานของ agent ประมวลผลบนคอมพิวเตอร์ของผู้ใช้ แทนที่จะส่งทุก prompt ไฟล์ และผลลัพธ์ไปยังบริการคลาวด์ Antigravity SDK เพิ่มการรองรับ workflow แบบนี้ผ่าน LiteRT-LM และโมเดล Gemma รวมถึงเซิร์ฟเวอร์ที่ใช้ API รูปแบบเดียวกับ OpenAI เช่น Ollama, LM Studio และ vLLM
คำว่า local ไม่ได้หมายความว่าองค์ประกอบทุกชิ้นต้องอยู่ในเครื่องเสมอไป ระบบสามารถออกแบบเป็น hybrid โดยให้โมเดลคลาวด์วางแผนจากข้อมูลจำกัด แล้วมอบงานที่ต้องอ่านโค้ดหรือไฟล์ละเอียดให้โมเดล local ทำต่อ
เหตุผลหลักที่ทีมอาจเลือกรัน agent ในเครื่อง
- ความเป็นส่วนตัว: โค้ดและไฟล์ที่ละเอียดอ่อนไม่จำเป็นต้องถูกส่งไปยังผู้ให้บริการโมเดลภายนอกในทุกขั้นตอน
- ทำงานออฟไลน์: ทำงานโดยไม่เรียกโมเดลคลาวด์ได้เมื่อเตรียมโมเดลและ runtime ครบแล้ว แต่ tools ที่ค้นเว็บ เรียก API หรือติดตั้งแพ็กเกจยังต้องใช้เครือข่าย
- ควบคุมต้นทุนเรียก API: งานซ้ำจำนวนมากสามารถใช้ทรัพยากรเครื่องที่มีอยู่ แทนการคิดค่าบริการตาม token
- ลดความหน่วงบางงาน: ไม่ต้องส่งข้อมูลไปกลับเครือข่าย แต่ความเร็วจริงยังขึ้นกับฮาร์ดแวร์และขนาดโมเดล
ตัวอย่าง hybrid แยก “ผู้วางแผน” กับ “ผู้ลงมือ”
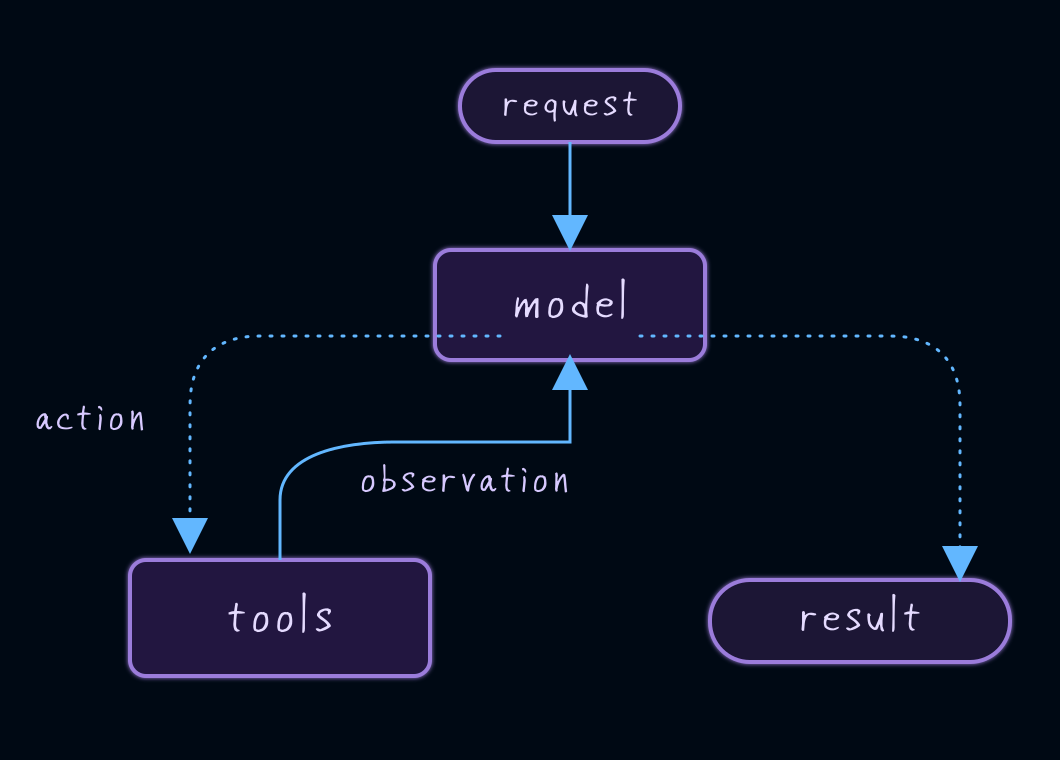
Google สาธิตโครงสร้างที่ใช้โมเดลคลาวด์เป็นสถาปนิก อ่านเพียงชื่อไฟล์และคำอธิบายงานเพื่อวางแผน จากนั้นให้โมเดล Gemma ในเครื่องตรวจช่องโหว่ สร้างแพตช์ วิจารณ์งาน และรันทดสอบกับโค้ดจริง ข้อมูลจากการสาธิตระบุว่าส่วนใหญ่ของ token ประมวลผลในเครื่อง
แนวทางนี้ช่วยลดข้อมูลที่ส่งออก แต่ต้องกำหนดให้ชัดว่าสองฝั่งรับส่งข้อมูลอะไรและทำสิ่งใดได้บ้าง แผนจากคลาวด์ต้องอยู่ภายใต้ข้อจำกัดของเครื่อง ส่วนผลที่ประมวลผลในเครื่องควรผ่านการตรวจก่อนส่งกลับหรือใช้เขียนทับไฟล์สำคัญ
ข้อจำกัดสำคัญคือฮาร์ดแวร์และการดูแล runtime
ตัวอย่าง Gemma 4 26B ในประกาศแนะนำเครื่องที่มี VRAM หรือ unified memory มากกว่า 24 GB ซึ่งสูงกว่าคอมพิวเตอร์ทั่วไปหลายเครื่อง โมเดลขนาดเล็กอาจใช้ทรัพยากรน้อยลง แต่คุณภาพ ความเร็ว และความสามารถใช้เครื่องมืออาจต่างกัน
การรัน local ยังเพิ่มภาระติดตั้งโมเดล จัดการเวอร์ชัน ตรวจไดรเวอร์ เฝ้าดูหน่วยความจำ และอัปเดตช่องโหว่ของ dependency ค่า API ที่ลดลงจึงไม่ได้แปลว่าต้นทุนรวมเป็นศูนย์ โดยเฉพาะเมื่อทีมต้องดูแลเครื่องหลายแบบ
ข้อมูลอยู่ในเครื่องไม่ได้แปลว่า agent ปลอดภัยโดยอัตโนมัติ
Agent local ยังสามารถลบไฟล์ รันคำสั่งผิด อ่าน secret หรือทำตาม prompt injection ที่แฝงในเอกสารได้ หากได้รับสิทธิ์มากเกินไป ควรจำกัด workspace และเครื่องมือ ใช้ sandbox ขออนุมัติก่อนการเปลี่ยนแปลงสำคัญ และบันทึกกิจกรรมที่ตรวจย้อนหลังได้
หาก workflow มีส่วน cloud ต้องทำ data-flow diagram ให้ชัดว่า metadata, prompt, log และผลลัพธ์ส่วนใดออกจากเครื่องบ้าง คำว่า hybrid อาจลดการส่งโค้ดดิบ แต่ยังมีข้อมูลอื่นที่อาจระบุตัวโครงการหรือปัญหาภายในได้
ตัวอย่างแผนตรวจเส้นทางข้อมูล: ใช้ไฟล์สมมติที่ไม่มีข้อมูลส่วนตัวหนึ่งชุด ระบุว่าโมเดลและเครื่องมือใดควรอ่านไฟล์นั้น แล้วตรวจการตั้งค่า provider กับบันทึกเครือข่ายของส่วนประกอบที่เกี่ยวข้อง หากเห็น request ออกไป ต้องแยกว่าดาวน์โหลดน้ำหนัก ส่ง prompt หรือเป็นบริการเครื่องมืออื่น อย่าอ้างว่าทั้ง workflow อยู่ในเครื่องจากการเห็น local model ทำงานเพียงส่วนเดียว บันทึกขอบเขตที่ตรวจไม่ได้ด้วย และไม่ทดลองด้วยไฟล์ลับเพื่อพิสูจน์ความเป็นส่วนตัว
เลือก local, cloud หรือ hybrid จากข้อกำหนดของงาน
Local เหมาะเมื่อข้อมูลอ่อนไหว ต้องทำงานออฟไลน์ และมีฮาร์ดแวร์เพียงพอ Cloud เหมาะเมื่ออยากเริ่มเร็ว ต้องใช้โมเดลขนาดใหญ่ หรือไม่ต้องการดูแล runtime ส่วน hybrid เหมาะเมื่อแยกข้อมูลและหน้าที่ได้ชัดเจน
Antigravity SDK ทำให้ตัวเลือกเหล่านี้อยู่ในกรอบ agent เดียวกันมากขึ้น แต่สถาปัตยกรรมที่เหมาะสมยังขึ้นกับ threat model งบประมาณ latency และคุณภาพที่ต้องการ ควรทดลองกับงานจริงขนาดเล็กก่อนขยายสิทธิ์ให้ agent แตะ codebase หรือระบบสำคัญ
แหล่งข้อมูล
บทความนี้อ้างอิงประกาศและตัวอย่างของ Google ณ วันที่ 7 ตุลาคม 2569 ตัวเลข token และผลการสาธิตเป็นกรณีตัวอย่าง ไม่ใช่คำรับประกันสำหรับทุกเครื่องหรือทุก codebase ผู้อ่านควรตรวจเอกสารและนโยบายความปลอดภัยล่าสุดก่อนนำไปใช้จริง