
Hermes Agent คืออะไร: เจาะสถาปัตยกรรม AI Agent ที่จำ เรียนรู้ และสร้างทักษะจากงานจริง
Hermes Agent พยายามแก้ปัญหาที่แชตบอตทั่วไปมักทำได้ไม่ดี: จำบริบทข้ามเซสชัน ใช้เครื่องมือหลายชนิด ทำงานต่อเนื่อง และนำบทเรียนจากงานเดิมกลับมาใช้ใหม่ บทความนี้จะแยกให้เห็นว่าอะไรคือความสามารถจริงของระบบ อะไรเป็นกลไกเบื้องหลังคำว่า self-improving และข้อจำกัดใดที่ควรเข้าใจก่อนนำไปใช้กับงานจริง
Hermes Agent คืออะไร และต่างจากแชตบอตอย่างไร
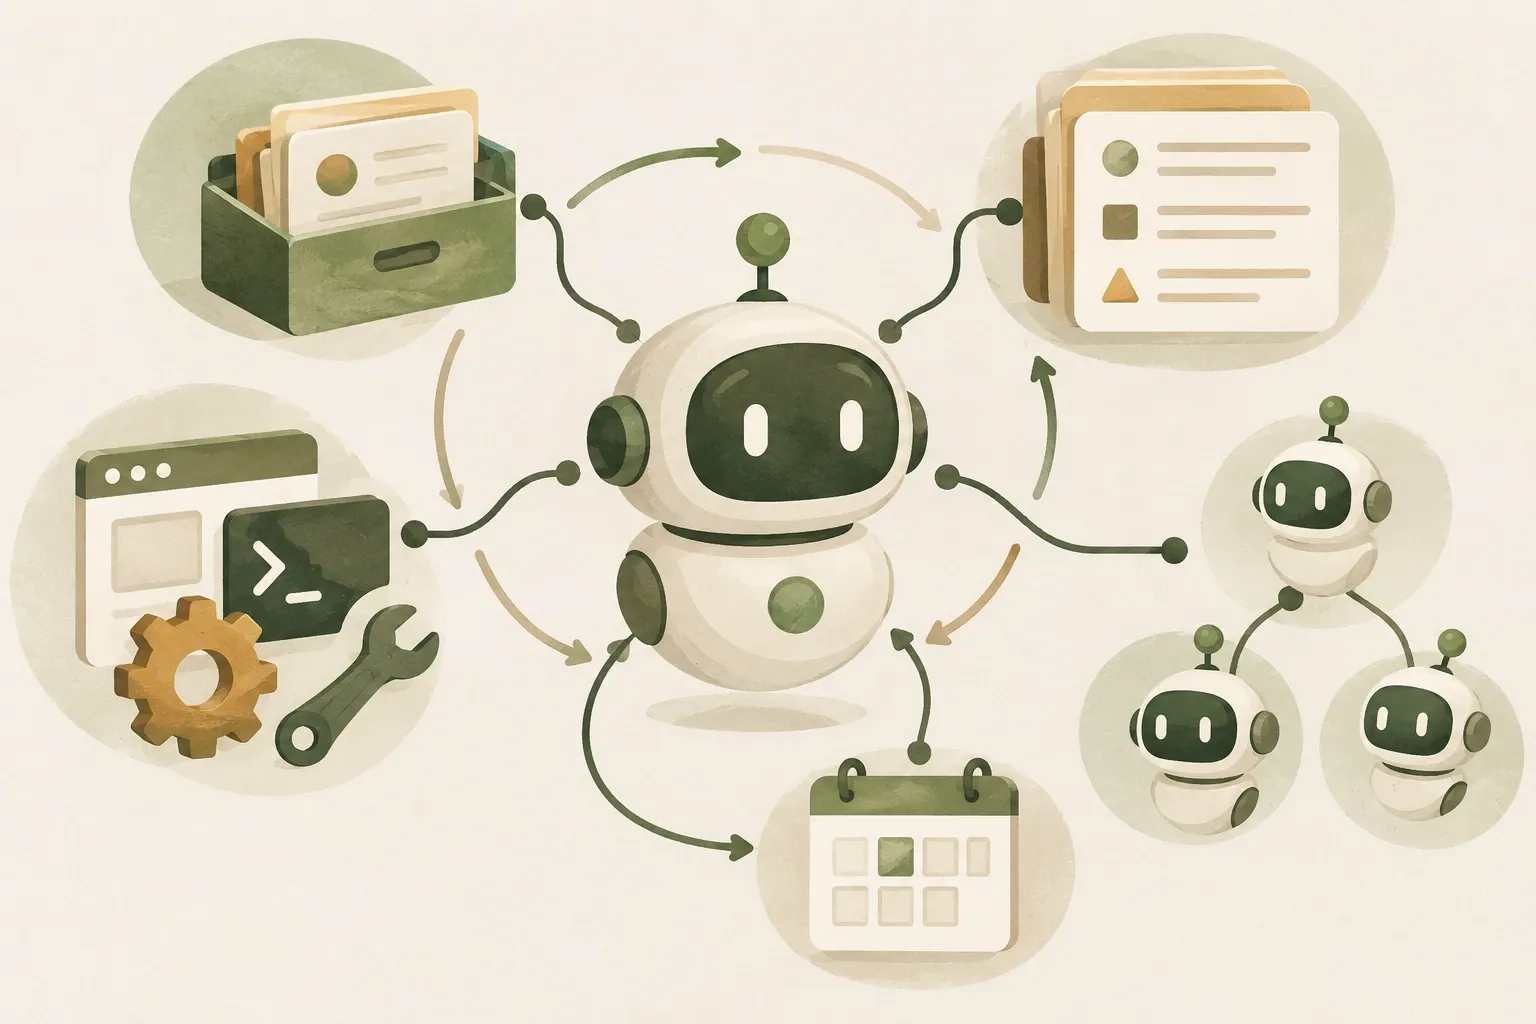
Hermes Agent คือโครงการ AI Agent แบบโอเพนซอร์สจาก Nous Research ที่วางตัวเองเป็น “เอเจนต์ที่เติบโตไปกับผู้ใช้” จุดสำคัญไม่ได้อยู่ที่มีโมเดลภาษาตัวใหม่เพียงตัวเดียว แต่อยู่ที่การสร้าง agent runtime ซึ่งครอบโมเดลภาษาไว้ด้วยระบบความจำ เครื่องมือ ทักษะ การจัดการเซสชัน การมอบหมายงานให้เอเจนต์ย่อย และระบบทำงานตามเวลา
ถ้ามองแบบง่ายที่สุด โมเดลภาษาเป็น “สมองที่ใช้คิดในแต่ละรอบ” ส่วน Hermes Agent เป็น “ระบบปฏิบัติการของงาน” ที่คอยจัดว่าโมเดลจะเห็นบริบทอะไร เรียกใช้เครื่องมือใด เก็บบทเรียนอะไรไว้ และส่งงานต่อให้กระบวนการอื่นอย่างไร ความแตกต่างนี้สำคัญ เพราะคำว่า self-improving ของ Hermes ไม่ได้แปลว่าโมเดลหลักถูกฝึกน้ำหนักใหม่ทุกครั้งหลังจบงาน แต่หมายถึงระบบสามารถปรับ memory, skills และบริบทการทำงาน เพื่อให้การทำงานครั้งต่อไปดีขึ้นหรือสอดคล้องกับผู้ใช้มากขึ้น
บทความนี้อ้าง release v0.21.3 ลงวันที่ 14 กันยายน 2569 เป็นจุดอ้างอิงเดิม ไม่ใช่การยืนยันว่าเป็นรุ่นล่าสุด ณ วันที่ผู้อ่านติดตั้ง เอกสารบนสาขา main อาจอธิบายความสามารถที่ต่างจากแพ็กเกจที่ติดตั้ง ให้เทียบเลขรุ่นและ release notes ของตนก่อนใช้คำสั่งหรือค่าเริ่มต้นในเอกสาร
แก่นของ Hermes คือ Agent Loop ไม่ใช่โมเดลตัวเดียว
หัวใจของระบบคือ agent loop ซึ่งรับข้อความจากผู้ใช้ ประกอบ system prompt เลือก provider และ model ส่งคำขอไปยังโมเดล ตีความการเรียกใช้เครื่องมือ รับผลลัพธ์กลับมา แล้ววนต่อจนงานเสร็จหรือถึงเงื่อนไขหยุด เอกสารสถาปัตยกรรมของโครงการระบุว่า loop นี้ยังรับผิดชอบเรื่อง retry, fallback, callbacks, context compression และ persistence ด้วย
ผลคือความสามารถของ Hermes เกิดจากหลายชั้นทำงานร่วมกัน ไม่ใช่จาก “ความฉลาดของโมเดล” เพียงอย่างเดียว ตัวอย่างเช่น โมเดลเดียวกันเมื่อรันแบบไม่มีเครื่องมืออาจตอบได้เพียงคำแนะนำ แต่เมื่ออยู่ใน Hermes และได้รับสิทธิ์ใช้ terminal, browser, file tools หรือ MCP ก็สามารถตรวจไฟล์ เรียก API ทำงานกับเว็บไซต์ และสร้างผลลัพธ์ที่นำไปใช้ต่อได้จริง
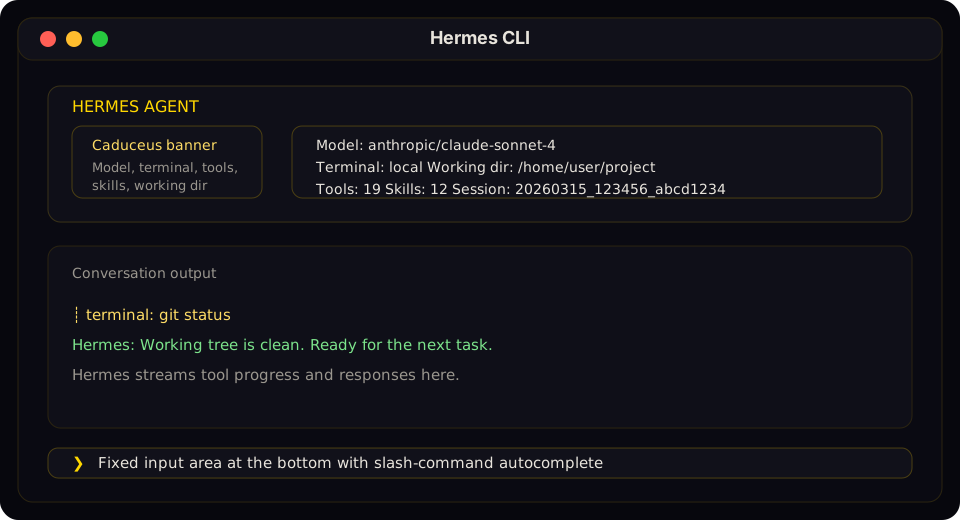
Prompt ของ Hermes ถูกประกอบเป็นหลายชั้น
ระบบ prompt ของ Hermes แบ่งข้อมูลสำคัญออกเป็นชั้นเพื่อควบคุมทั้งความถูกต้องและต้นทุน token เอกสารของโครงการอธิบายโครงสร้างหลักเป็นสามกลุ่ม ได้แก่ stable, context และ volatile
- Stable: ข้อมูลที่เปลี่ยนไม่บ่อย เช่น identity, แนวทางการใช้เครื่องมือ และ operating brief
- Context: คำสั่งจากผู้เรียกใช้ ไฟล์บริบทของโปรเจกต์ เช่น AGENTS.md หรือ CLAUDE.md รวมถึงข้อมูล workspace ที่เกี่ยวกับงานปัจจุบัน
- Volatile: ข้อมูลที่เปลี่ยนตามเซสชัน เช่น skills index, memory, user profile, เวลา โมเดล provider และข้อมูล runtime
การแยกชั้นนี้ทำให้ Hermes สามารถใช้ prompt caching ได้มีประสิทธิภาพขึ้น และยังช่วยอธิบายว่าทำไม “ความจำ” ของระบบจึงไม่เหมือนการยัดประวัติแชตทั้งหมดเข้าไปทุกครั้ง สิ่งที่ควรคงอยู่ระยะยาวจะถูกสรุปเป็น memory หรือ skill ขณะที่บทสนทนายาว ๆ สามารถถูกบีบอัดเมื่อเข้าใกล้ขีดจำกัด context window
Memory ของ Hermes เป็นความจำแบบคัดเลือก ไม่ใช่การเก็บทุกอย่าง
Hermes มี persistent memory ที่ถูกออกแบบให้มีขนาดจำกัดและผ่านการคัดเลือก เอกสารระบุไฟล์หลักสองส่วนคือ MEMORY.md สำหรับข้อเท็จจริงเกี่ยวกับสภาพแวดล้อม กฎการทำงาน และสิ่งที่เอเจนต์เรียนรู้ กับ USER.md สำหรับความชอบ รูปแบบการสื่อสาร และความคาดหวังของผู้ใช้ โดยค่าเริ่มต้นมีเพดานประมาณ 2,200 และ 1,375 ตัวอักษรตามลำดับ
การจำกัดพื้นที่ memory ช่วยบังคับให้เอเจนต์เลือกข้อมูลที่ควรเก็บ หากปล่อยให้โตโดยไม่จำกัด ระบบจะใช้ token เพิ่มและอาจนำข้อมูลเก่าหรือเรื่องที่ไม่เกี่ยวข้องมาปะปนในคำตอบใหม่ จึงต้องคัดและสรุปสิ่งที่จะจำ แทนการเก็บทุกประโยค
อย่างไรก็ตาม memory ไม่ใช่ฐานความจริงที่เชื่อถือได้โดยอัตโนมัติ ถ้าเอเจนต์บันทึกข้อสรุปที่ผิดหรือข้อมูลที่ล้าสมัย ข้อผิดพลาดนั้นอาจถูกนำกลับมาใช้ในอนาคตได้ Hermes จึงมีตัวเลือก memory.write_approval เพื่อให้การเขียน memory ต้องผ่านการอนุมัติก่อนในสภาพแวดล้อมที่ต้องการการควบคุมมากขึ้น
เอกสาร Memory ที่ตรวจเพิ่มเติมวันที่ 29 ตุลาคม 2569 เตือนไม่ให้สอง agent process เขียน Hermes home เดียวกัน เพราะแต่ละตัวอาจต่อเติมความจำที่อีกตัวสร้างไว้ ให้แยก profile สำหรับ agent อีกตัว และพิจารณา memory provider ภายนอกเมื่อจำเป็นต้องแบ่งปันข้อมูล การมีไฟล์ความจำร่วมไม่ได้สร้างขอบเขตสิทธิ์หรือแก้ปัญหาการเขียนพร้อมกันให้เอง
Skills คือ “procedural memory” หรือความจำว่าควรทำงานอย่างไร
ถ้า memory ตอบคำถามว่า “ควรจำอะไร” skills จะตอบว่า “งานแบบนี้ควรทำอย่างไร” Hermes สามารถสร้าง แก้ไข และลบทักษะผ่านระบบ skill_manage โดยเก็บขั้นตอนที่ค้นพบว่าใช้ได้ผลไว้เป็นไฟล์คำสั่งสำหรับเรียกใช้ในอนาคต
ตัวอย่างสมมติ: หากผู้ใช้ให้ Hermes ทำรายงานคู่แข่งทุกสัปดาห์ ครั้งแรกเอเจนต์อาจต้องลองหลายวิธีเพื่อค้นว่าเว็บไซต์ใดควรตรวจ ข้อมูลใดควรกรอง และควรจัดรูปแบบอย่างไร เมื่อขั้นตอนลงตัว ระบบสามารถบันทึกวิธีนั้นเป็น skill ครั้งต่อไปจึงไม่ต้องเริ่มคิดกระบวนการจากศูนย์ทุกครั้ง
นี่คือจุดที่คำว่า self-improving ของ Hermes มีความหมายเชิงปฏิบัติจริงที่สุด: สิ่งที่พัฒนาคือ “กระบวนการทำงานของเอเจนต์” ไม่จำเป็นต้องเป็นน้ำหนักของโมเดลภาษา เมื่อระบบพบทางที่ดีกว่า เจอข้อผิดพลาด หรือได้รับการแก้ไขจากผู้ใช้ ก็สามารถปรับ skill เดิมให้ดีขึ้นได้
Background review ทำให้การเรียนรู้เกิดหลังจบงาน
Hermes มี background self-improvement review ที่สามารถย้อนดูบทสนทนาแล้วพิจารณาว่ามีสิ่งใดควรถูกบันทึกเป็น memory หรือปรับเป็น skill ระบบนี้ช่วยลดภาระที่ผู้ใช้ต้องสั่ง “จำเรื่องนี้” ทุกครั้ง และทำให้การเรียนรู้เกิดเป็นวงจรต่อเนื่องมากขึ้น
แต่การทำงานอัตโนมัติลักษณะนี้ก็เพิ่มความเสี่ยง เพราะเอเจนต์อาจตีความผิดว่าสิ่งใดควรจำหรือควรเปลี่ยน workflow โครงการจึงมี approval gate สำหรับทั้ง memory และ skills เมื่อเปิดใช้ การเปลี่ยนแปลงจะถูกพักไว้ให้ผู้ใช้ตรวจ diff และอนุมัติก่อนนำไปใช้จริง
อีกชั้นหนึ่งคือ Curator ซึ่งดูแล skill ที่เอเจนต์สร้างขึ้น ลดปัญหาทักษะซ้ำ ทักษะเก่า หรือ catalog ที่โตจนกิน context โดยระบบสามารถติดตามการใช้งานและย้าย skill ที่ไม่ค่อยใช้ไปสู่สถานะ stale หรือ archived ได้
Toolsets ทำให้ Hermes เป็นระบบลงมือทำ ไม่ใช่แค่ระบบตอบ
Hermes แบ่งเครื่องมือเป็น toolsets เพื่อควบคุมว่าระหว่างเซสชันหนึ่ง ๆ เอเจนต์ทำอะไรได้บ้าง หมวดสำคัญครอบคลุม web, terminal, file, browser, vision, image generation, memory, cron, delegation และ code execution อย่างไรก็ตาม การที่ Hermes รองรับ toolset เหล่านี้ไม่ได้หมายความว่าเครื่องมือทุกชนิดจะใช้งานได้ในทุก deployment เพราะความสามารถที่เปิดใช้จริงยังขึ้นอยู่กับ configuration, credentials, provider ตลอดจน policy และสิทธิ์ที่ผู้ดูแลระบบกำหนด
หลักคิดนี้ช่วยเรื่องความปลอดภัยและความชัดเจนของสิทธิ์ หากงานต้องการเพียงอ่านเว็บและสรุปข้อมูล ก็ไม่จำเป็นต้องให้สิทธิ์ terminal หรือ file write เพิ่มโดยไม่จำเป็น ในทางกลับกัน งานพัฒนาโปรแกรมอาจเปิด file, terminal และ web พร้อมกันเพื่อให้เอเจนต์อ่านโค้ด รันคำสั่ง และตรวจเอกสารภายนอกได้
เครื่องมือจึงเป็นส่วนที่เปลี่ยน LLM จากผู้สร้างข้อความให้กลายเป็นเอเจนต์ที่สร้างผลกระทบต่อระบบจริง และยิ่งเปิดสิทธิ์มากเท่าใด การออกแบบ approval, sandbox และการตรวจสอบผลลัพธ์ก็ยิ่งสำคัญขึ้นเท่านั้น
MCP ขยาย Hermes ออกไปนอกเครื่องมือที่ติดมากับระบบ
Hermes รองรับ Model Context Protocol หรือ MCP เพื่อเชื่อมกับ tool server ภายนอก เช่น GitHub, ฐานข้อมูล, file systems, browser stacks หรือ internal APIs โดยไม่จำเป็นต้องเขียน native tool เข้าไปใน Hermes ทุกครั้ง
ข้อดีของ MCP คือช่วยแยก “ระบบเอเจนต์” ออกจาก “ระบบเครื่องมือ” องค์กรสามารถคง API หรือ service เดิมไว้ แล้วเปิดความสามารถบางส่วนผ่าน MCP ให้เอเจนต์เรียกใช้ได้ พร้อมกำหนด filtering ว่า server หนึ่งจะเปิดเผยเครื่องมือใดบ้าง
ในเชิงสถาปัตยกรรม นี่ทำให้ Hermes ใกล้เคียงแพลตฟอร์ม orchestration มากกว่าแอปแชต เพราะขอบเขตความสามารถของมันสามารถเพิ่มขึ้นตาม ecosystem ของ tools โดยไม่ต้องรอให้ทีมหลักนำ integration ทุกอย่างเข้า core
Subagents ช่วยแยกบริบทและทำงานหลายสายพร้อมกัน
Hermes สามารถมอบหมายงานให้ subagent เพื่อทำงานย่อยแยกจากบริบทหลัก เอกสารระบุว่าแต่ละ subagent มี conversation และ terminal session ของตัวเอง ขณะที่ผลลัพธ์สุดท้ายถูกส่งกลับไปยัง agent หลัก แนวทางนี้ช่วยลดปัญหา context หลักเต็มไปด้วย intermediate output จำนวนมาก
ตัวอย่างเช่น งานวิจัยเชิงลึกหนึ่งชิ้นอาจแบ่งเป็นสามสาย ได้แก่ ตรวจเอกสารทางการ วิเคราะห์ repository และรวบรวมประเด็นความปลอดภัย จากนั้น agent หลักค่อยรวมคำตอบอีกครั้ง วิธีนี้ทำให้แต่ละสายมีบริบทที่สะอาดและสามารถทำงานคู่ขนานกันได้
อย่างไรก็ดี subagent ไม่ได้ถูกปล่อยให้มีสิทธิ์ทุกอย่างโดยอัตโนมัติ มันสืบทอด toolsets จาก parent และเครื่องมือที่มี side effect บางประเภทถูกจำกัด เช่น การเขียน shared memory การส่งข้อความข้ามแพลตฟอร์ม หรือการสร้าง cron ในนามของ parent นี่เป็นตัวอย่างของการลด blast radius ภายในระบบ multi-agent
Cron ทำให้ Agent เปลี่ยนจาก “ตอบเมื่อถูกถาม” เป็น “ทำงานตามเวลา”
Hermes มีระบบ scheduled tasks ที่ใช้ cron เป็นองค์ประกอบระดับแรกของแพลตฟอร์ม งานสามารถเป็นแบบครั้งเดียวหรือทำซ้ำ และสามารถแนบ skills หรือ script เข้าไปก่อนเริ่ม agent turn ได้ ผลลัพธ์สามารถส่งกลับไปยังแชต ไฟล์ หรือแพลตฟอร์มที่กำหนดไว้
เมื่อรวม cron กับ memory และ skills จะเกิด workflow ที่มีลักษณะต่อเนื่องมากขึ้น เช่น ตรวจ changelog ทุกเช้า สรุปเฉพาะสิ่งที่เปลี่ยนจากครั้งก่อน ใช้รูปแบบรายงานที่เคยบันทึกเป็น skill แล้วส่งกลับไปยังช่องทางเดิม นี่เป็นระดับของ automation ที่แชตบอตทั่วไปไม่สามารถทำได้หากไม่มี runtime ภายนอกมาช่วย
Hermes ไม่ผูกกับโมเดลเดียว และนี่มีผลต่อคุณภาพมาก
ระบบรองรับ provider หลายแบบ ทั้งบริการ cloud, OpenAI-compatible endpoint และโมเดลที่รันเอง ผู้ใช้สามารถเปลี่ยน model/provider โดยไม่ต้องเปลี่ยน agent architecture ทั้งชุด
ข้อดีคือแยก “ความสามารถในการคิดของโมเดล” ออกจาก “ความสามารถด้าน orchestration” ของ Hermes ผู้ใช้จึงสามารถเลือกโมเดลเร็วและประหยัดสำหรับงานประจำ แล้วใช้โมเดลที่แข็งแรงกว่าในงาน reasoning หนัก หรือกำหนด fallback เมื่อ provider แรกใช้งานไม่ได้
แต่ความยืดหยุ่นนี้มีข้อควรระวังเช่นกัน เพราะโมเดลแต่ละตัวมีความสามารถด้าน tool use, context length, reasoning และรูปแบบ error ต่างกัน Workflow ที่ทำงานดีบนโมเดลหนึ่งอาจทำงานแย่ลงเมื่อเปลี่ยน provider แม้ Hermes จะพยายามทำ abstraction ให้เหมือนกันก็ตาม
Context compression ช่วยให้คุยนานได้ แต่ไม่มีการบีบอัดแบบไร้ความสูญเสียโดยอัตโนมัติทุกกรณี
เมื่อบทสนทนายาวใกล้ context limit Hermes สามารถบีบอัดประวัติกลางของบทสนทนาให้เป็น summary แล้วเก็บช่วงล่าสุดไว้ เพื่อเปิดพื้นที่ให้ agent ทำงานต่อ วิธีนี้ช่วยลดโอกาสที่เซสชันยาวจะชนเพดาน token
ข้อแลกเปลี่ยนคือ summary อาจทำรายละเอียดบางอย่างหายไปหรือเปลี่ยนน้ำหนักของข้อมูลเดิมได้ ดังนั้นงานที่ต้องอาศัยข้อกำหนดจำนวนมากหรือหลักฐานเฉพาะประโยค ไม่ควรถือว่าบริบทก่อนหน้าจะถูกเก็บแบบสมบูรณ์เสมอ แม้ระบบจะมี session search และโครงสร้างช่วยเรียกข้อมูลกลับมาใช้อีกครั้ง
Security ของ Agent ต้องมองต่างจาก Security ของ Chatbot
แชตบอตที่ตอบข้อความอย่างเดียวมีพื้นผิวความเสี่ยงจำกัดกว่าเอเจนต์ที่เขียนไฟล์ รันคำสั่ง และควบคุม browser Hermes จึงออกแบบระบบป้องกันหลายชั้น เช่น user authorization, approval สำหรับคำสั่งอันตราย, file-write safety, container isolation, การกรอง credential ของ MCP, context-file scanning, cross-session isolation และ input sanitization
อย่างไรก็ตาม สิ่งเหล่านี้ไม่ทำให้การเปิดสิทธิ์สูงแก่เอเจนต์กลายเป็นเรื่องปลอดภัยโดยอัตโนมัติ ผู้ใช้ยังต้องตัดสินใจเรื่องสิทธิ์ของ toolsets, credential, network access และ sandbox ให้เหมาะกับระดับความเสียหายที่ยอมรับได้ โดยเฉพาะเมื่อ agent ทำงานกับโค้ด production ข้อมูลลับ หรือระบบที่มีสิทธิ์เปลี่ยนแปลงทรัพยากรจริง
จุดแข็งจริงของ Hermes Agent อยู่ที่ “วงจรการทำงานที่สะสมได้”
Hermes นำผลจากการทำงานกลับมาใช้ปรับความจำและขั้นตอน ผ่านวงจรต่อไปนี้:
- ทำงาน: โมเดลใช้ tools เพื่อแก้ปัญหาในสภาพแวดล้อมจริง
- สังเกตผล: ระบบเห็นว่าขั้นตอนไหนสำเร็จ ล้มเหลว หรือถูกผู้ใช้แก้ไข
- กลั่นความรู้: ข้อเท็จจริงที่ควรจำไปอยู่ใน memory ส่วนกระบวนการไปอยู่ใน skills
- นำกลับมาใช้: เซสชันใหม่โหลดความจำและค้น skill ที่เกี่ยวข้องแทนการเริ่มจากศูนย์
- ดูแลของเก่า: background review และ curator ช่วยแก้ ปรับ หรือจัดระเบียบสิ่งที่สะสมไว้
หากวงจรนี้ทำงานได้ดี ระบบจะค่อย ๆ เก็บวิธีทำงานที่เหมาะกับทีม โครงการ หรือผู้ใช้แต่ละคน การปรับให้เข้ากับงานจึงเกิดจากการใช้งานจริง โดยไม่ต้องอาศัยการเพิ่มความยาว prompt อย่างเดียว
แต่คำว่า Self-Improving มีขอบเขตที่ต้องเข้าใจให้ถูก
การที่ Hermes สร้าง skill หรืออัปเดต memory ไม่ได้แปลว่าโมเดลมีความสามารถพื้นฐานเพิ่มขึ้นทุกด้าน โมเดลยังคงมีข้อจำกัดด้าน reasoning, hallucination และความรู้เช่นเดิม ระบบเพียงเพิ่มโอกาสให้โมเดลเข้าถึงบริบทและขั้นตอนที่มีประโยชน์มากขึ้นในครั้งถัดไป
ดังนั้นควรแยกสามสิ่งออกจากกัน:
- Model improvement: การเปลี่ยนน้ำหนักหรือฝึกโมเดล ซึ่งไม่ใช่สิ่งที่เกิดขึ้นทุกครั้งจากการใช้ Hermes ตามปกติ
- Context improvement: การมี memory หรือข้อมูลโปรเจกต์ที่เหมาะสมขึ้น
- Workflow improvement: การบันทึกและแก้ไข skills ให้ทำงานซ้ำได้ดีขึ้น
Hermes เด่นในสองข้อหลัง และนั่นเพียงพอที่จะทำให้ประสบการณ์ใช้งานรู้สึกว่าเอเจนต์ “เก่งขึ้น” เมื่อใช้ไปนาน ๆ แม้ตัวโมเดลหลักจะเป็นรุ่นเดิมก็ตาม
ข้อจำกัดของ Hermes ด้านโมเดล ความจำ และการดูแลระบบ
- Memory ผิดได้: ถ้าเอเจนต์สรุปข้อมูลผิด ความผิดนั้นอาจกลายเป็นบริบทถาวรจนกว่าจะถูกแก้
- Skill เสื่อมได้: Workflow ที่เคยใช้ได้อาจล้าสมัยเมื่อ API, CLI หรือเว็บไซต์เปลี่ยน
- Tool use เพิ่มความเสี่ยง: ยิ่ง agent มีสิทธิ์เขียนไฟล์ รันคำสั่ง หรือเรียกบริการภายนอกมาก ความเสียหายจากการตัดสินใจผิดก็สูงขึ้น
- ค่าใช้จ่ายไม่ใช่เฉพาะคำตอบหลัก: Background review, compression, delegation และงานตามเวลาอาจสร้าง LLM calls เพิ่ม
- คุณภาพขึ้นกับโมเดล: Runtime ที่ดีไม่สามารถชดเชยโมเดลที่ใช้เครื่องมือไม่แม่นหรือ reasoning ไม่พอได้ทั้งหมด
- บริบทถูกบีบอัด: เซสชันยาวอาจสูญเสียรายละเอียดบางส่วนเมื่อผ่าน summarization
- โครงการเปลี่ยนเร็ว: เอกสาร ชื่อเครื่องมือ และ provider support อาจเปลี่ยนตาม release จึงควรตรวจเวอร์ชันก่อนทำ deployment
Hermes เหมาะกับงานแบบไหน
Hermes น่าสนใจสำหรับผู้ใช้ที่ต้องทำงานซ้ำหลายขั้นตอนและต้องการให้ agent จำวิธีทำงานข้ามเซสชัน เช่น งานวิจัยที่มี pipeline ชัดเจน งานพัฒนาซอฟต์แวร์ งานดูแลระบบ งานจัดทำรายงานซ้ำ งานที่ต้องเชื่อมหลาย API หรือทีมที่ต้องการ agent ส่วนตัวซึ่งรันบน infrastructure ของตนเอง
ในทางกลับกัน หากงานมีเพียงถามตอบสั้น ๆ ไม่ต้องใช้เครื่องมือ ไม่ต้องจำข้ามเซสชัน และไม่ต้องทำ automation สถาปัตยกรรมแบบ Hermes อาจซับซ้อนเกินความจำเป็น เพราะคุณค่าหลักของมันจะเกิดขึ้นเมื่อ memory, skills, tools และ scheduling ถูกใช้งานร่วมกัน
วิธีทดสอบ Hermes Agent กับงานของทีม
ตัวอย่างสมมติสำหรับทดลองรายงานคู่แข่งรายสัปดาห์: ใช้ changelog สาธารณะสองฉบับที่ตรวจวันไว้แล้ว ให้ Agent ส่งเฉพาะรายการที่เพิ่มหรือเปลี่ยน พร้อม URL และข้อความรองรับ เมื่อรอบถัดไปไม่มีฉบับใหม่ ผลที่ผ่านเกณฑ์คือบอกว่าไม่พบการเปลี่ยนแปลง ไม่สร้างข่าวเพิ่มเพื่อให้รายงานดูครบ ตรวจทั้งไฟล์รายงาน บันทึกการเรียกเครื่องมือ และ skill ที่ถูกเสนอให้แก้ หากยังไม่ได้ทดสอบว่าตารางเวลาทำงานจริง ให้บันทึกว่าเส้นทาง cron ยังไม่ผ่าน แยกจากความถูกต้องของรายงาน
ก่อนตัดสินใจใช้ระบบลักษณะนี้ ควรประเมินด้วยคำถามที่เป็นรูปธรรมมากกว่าดูเพียงจำนวนฟีเจอร์:
- งานของเรามีขั้นตอนซ้ำที่ควรถูกบันทึกเป็น skill หรือไม่
- มีข้อมูลอะไรที่ควรจำข้ามเซสชัน และอะไรที่ไม่ควรถูกเก็บ
- Agent ต้องมีสิทธิ์กับเครื่องมือใดบ้าง และสิทธิ์ใดควรบังคับ approval
- เมื่อ workflow ผิด เราจะตรวจและย้อนกลับการเปลี่ยนแปลงอย่างไร
- งานใดควรรันใน sandbox แทนเครื่องหลัก
- LLM calls เพิ่มจาก cron, review หรือ delegation คุ้มกับเวลาที่ประหยัดได้หรือไม่
คำถามเหล่านี้ทำให้การประเมินเปลี่ยนจาก “Agent ตัวนี้ฉลาดแค่ไหน” ไปเป็น “ระบบนี้ทำงานซ้ำของเราให้มีประสิทธิภาพและควบคุมได้จริงหรือไม่” ซึ่งเป็นเกณฑ์ที่ใกล้กับคุณค่าทางปฏิบัติมากกว่า
Hermes Agent เป็นตัวอย่างของการเปลี่ยนจาก Chat Interface ไปสู่ Agent Runtime
ความสามารถของ Hermes Agent ขึ้นกับทั้งโมเดลภาษา โครงสร้างความจำ สิทธิ์เครื่องมือ การประสานงาน ตารางเวลา การจัดบริบท และวิธีนำบทเรียนจากงานเดิมกลับมาใช้ จึงต้องดูส่วนเหล่านี้ร่วมกันเมื่อประเมินระบบ
จุดเด่นที่สุดคือการทำให้ memory สำหรับข้อเท็จจริง และ skills สำหรับกระบวนการ กลายเป็นส่วนหนึ่งของวงจรทำงานปกติ เมื่อรวมกับ subagents, MCP, cron และ provider abstraction ระบบจึงสามารถทำหน้าที่เป็นเอเจนต์ระยะยาวมากกว่าเป็นเพียงหน้าต่างแชต
แต่ความสามารถที่มากขึ้นมาพร้อมความรับผิดชอบที่มากขึ้นเช่นกัน โดยเฉพาะเรื่องสิทธิ์ของเครื่องมือ ความถูกต้องของ memory การเสื่อมของ skills และการตรวจสอบงานที่มี side effect หากมอง Hermes ด้วยกรอบนี้ จะเห็นทั้งศักยภาพและข้อจำกัดได้ชัดกว่าการตีความคำว่า “self-improving AI” ว่าเป็นโมเดลที่พัฒนาตัวเองแบบไร้ขอบเขต
แหล่งข้อมูล
- Nous Research: Hermes Agent Documentation
- Nous Research: Hermes Agent Architecture
- Nous Research: Persistent Memory
- Nous Research: Skills System
- Nous Research: Curator
- Nous Research: Security
- Nous Research: Subagent Delegation
- Nous Research: Model Context Protocol (MCP)
- Nous Research: LLM and Model Providers
- NousResearch/hermes-agent: Releases
- NousResearch/hermes-agent: MIT License
ตรวจสอบเอกสารและหน้า Release ของ Hermes Agent เมื่อ 2 ตุลาคม 2569 ฟีเจอร์ ค่าเริ่มต้น ชื่อคำสั่ง และสถาปัตยกรรมอาจเปลี่ยนแปลงได้ตามเวอร์ชัน ควรตรวจสอบเอกสารของรุ่นที่ใช้งานจริงก่อนตั้งค่าระบบสำคัญ