
EmbeddingGemma 2 คืออะไร? โมเดล Embedding มัลติโหมด 740M ที่รันบนอุปกรณ์ได้
EmbeddingGemma 2 เป็นโมเดล embedding แบบมัลติโหมดจาก Google DeepMind ที่แปลงข้อความ โค้ด ภาพ วิดีโอ และเสียงให้อยู่ในพื้นที่เวกเตอร์เดียวกัน เพื่อนำไปค้นหาและเปรียบเทียบความหมายข้ามชนิดข้อมูล โดยออกแบบขนาดโมเดลให้เหมาะกับการรันบนอุปกรณ์
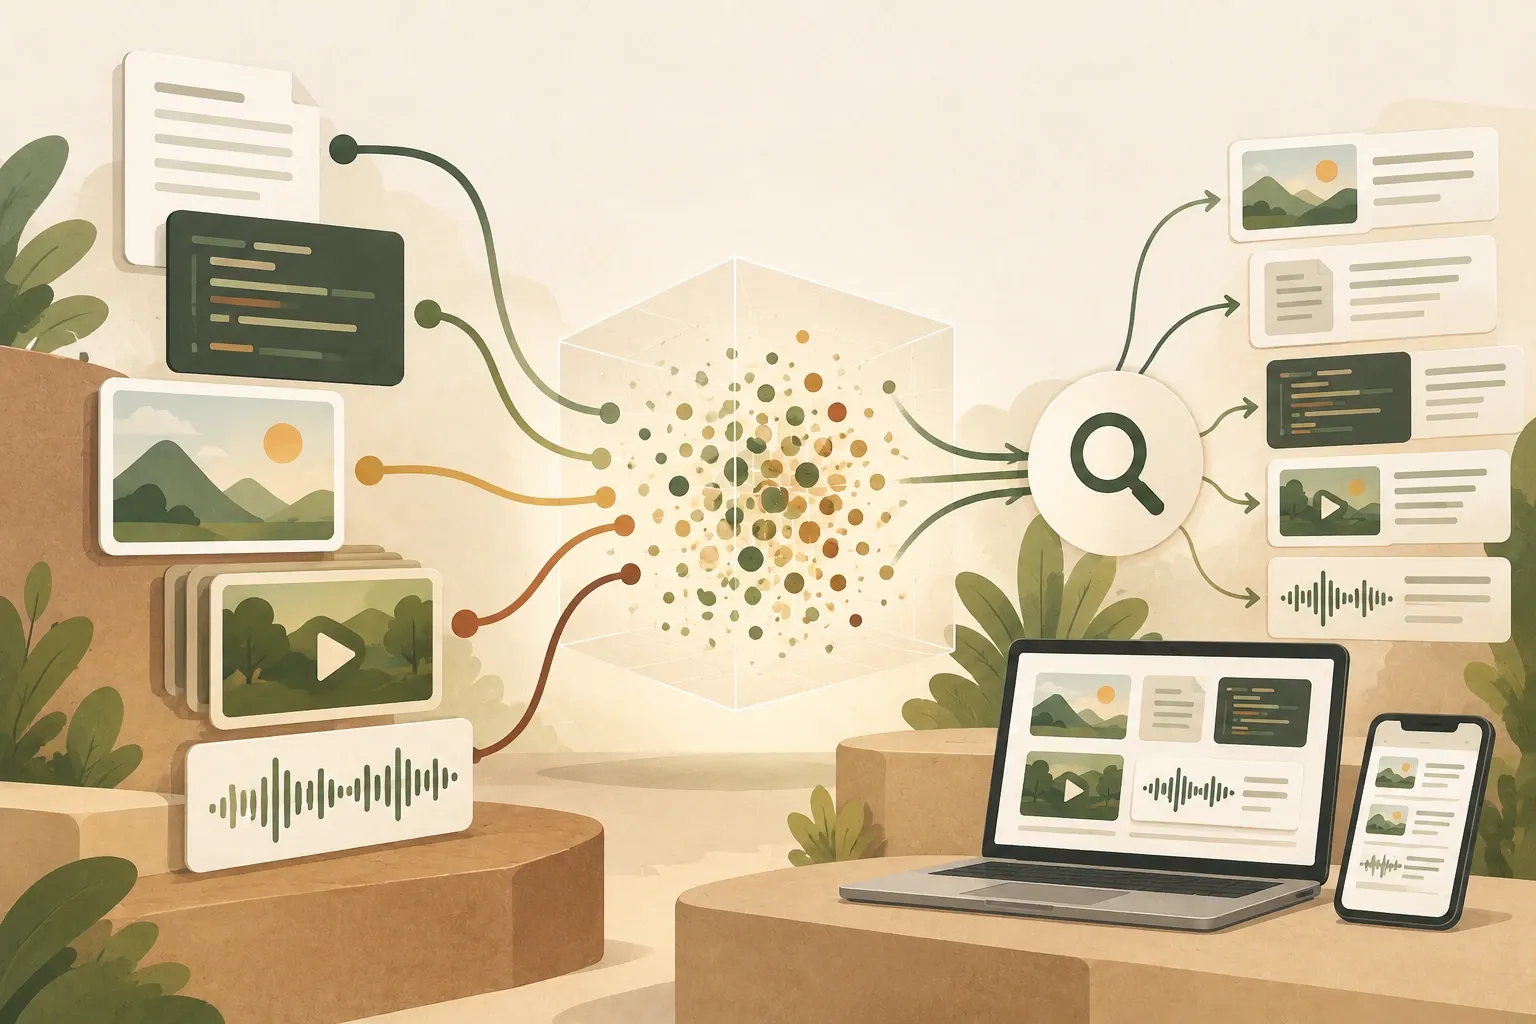
EmbeddingGemma 2 คืออะไร และต่างจาก AI ที่สร้างข้อความอย่างไร
EmbeddingGemma 2 เป็นโมเดลสำหรับสร้าง embedding หรือเวกเตอร์ตัวเลขที่แทน “ความหมาย” ของข้อมูล ไม่ได้มีหน้าที่หลักในการตอบคำถามหรือสร้างข้อความเหมือนโมเดลแชต เมื่อข้อมูลสองชิ้นมีความหมายใกล้กัน เวกเตอร์ของข้อมูลเหล่านั้นก็มักอยู่ใกล้กันในพื้นที่คณิตศาสตร์ จึงนำไปใช้กับงานค้นหา จัดกลุ่ม แนะนำเนื้อหา และ Retrieval-Augmented Generation (RAG) ได้
จุดที่ Google เน้นในรุ่นนี้คือการรวมหลายชนิดข้อมูลไว้ในพื้นที่เดียวกัน EmbeddingGemma 2 รองรับข้อความ โค้ด ภาพ วิดีโอ และเสียง แล้วแปลงทั้งหมดไปยัง vector space ขนาด 768 มิติ ทำให้คำค้นที่เป็นข้อความสามารถใช้ค้นหารูป วิดีโอ หรือเสียงตาม “ความหมาย” ได้โดยไม่จำเป็นต้องแปลงทุกอย่างเป็นข้อความก่อนเสมอไป
ค้นหาข้ามชนิดข้อมูลในพื้นที่เวกเตอร์เดียวกันได้อย่างไร
ระบบค้นหาแบบเดิมมักต้องมีโมเดลหลายตัวต่อกัน เช่น แปลงเสียงเป็นข้อความ สร้างคำบรรยายภาพ แล้วค่อยส่งข้อความเหล่านั้นเข้า text embedding อีกที วิธีนี้เพิ่มทั้งความซับซ้อน เวลาในการประมวลผล และโอกาสที่ข้อมูลบางส่วนจะสูญหายระหว่างการแปลง
EmbeddingGemma 2 พยายามลดขั้นตอนดังกล่าวด้วย encoder สำหรับแต่ละโมดัล แต่ให้ผลลัพธ์สุดท้ายอยู่ในพื้นที่เวกเตอร์เดียวกัน ตัวอย่างเช่น ผู้ใช้สามารถพิมพ์ว่า “ช่วงที่มีคนกำลังประกอบจักรยาน” แล้วค้นหาช่วงที่เกี่ยวข้องในวิดีโอ หรือใช้ภาพหนึ่งภาพเพื่อค้นหารูปและคลิปที่มีความหมายใกล้เคียงกันได้
โครงสร้าง 740M Parameters ไม่ได้หมายความว่าต้องโหลดทั้งหมดทุกครั้ง
- ข้อความและโค้ด: ส่วนฐานใช้ประมาณ 270 ล้านพารามิเตอร์ และรองรับ context สูงสุด 8,192 tokens
- ภาพและวิดีโอ: เพิ่ม vision encoder ประมาณ 170 ล้านพารามิเตอร์ ทำให้ชุด text + vision อยู่ที่ประมาณ 440 ล้านพารามิเตอร์
- เสียง: audio encoder มีประมาณ 300 ล้านพารามิเตอร์ ชุด text + audio จึงอยู่ที่ประมาณ 570 ล้านพารามิเตอร์
- มัลติโหมดเต็มรูปแบบ: เมื่อใช้ทุกส่วนรวมกัน โมเดลมีประมาณ 740 ล้านพารามิเตอร์
แนวคิดแบบ modular นี้สำคัญกับงาน on-device เพราะแอปไม่จำเป็นต้องแบก encoder ที่ไม่ได้ใช้ Google ระบุว่าบน Pixel 11 Pro หลัง quantization น้ำหนักสำหรับงานข้อความอย่างเดียวใช้ active RAM ได้ต่ำราว 191 MB ส่วนโมเดลมัลติโหมดเต็มรูปแบบอยู่ราว 567 MB ตัวเลขนี้ควรมองเป็นผลทดสอบบนฮาร์ดแวร์และการตั้งค่าของ Google ไม่ใช่ค่าที่รับประกันว่าจะเหมือนกันทุกอุปกรณ์
8K Context และการค้นหาข้ามข้อความ ภาพ วิดีโอ และเสียง
EmbeddingGemma 2 ขยาย context window เป็น 8K tokens ซึ่ง Google ระบุว่าสามารถรองรับข้อมูลต่อครั้งได้ประมาณเสียงยาวสูงสุด 5.5 นาที ภาพ 29 ภาพ หรือ 58 เฟรมวิดีโอ ขึ้นอยู่กับรูปแบบอินพุตและการจัดสรร token ภายในโมเดล
ประโยชน์เชิงปฏิบัติคือการสร้าง embedding สำหรับข้อมูลที่ยาวหรือมีหลายส่วนได้โดยไม่ต้องตัดเป็นชิ้นเล็กมากเสมอไป แต่ในระบบจริง นักพัฒนายังต้องออกแบบวิธีแบ่งข้อมูลให้เหมาะกับงาน เพราะ context ที่ยาวขึ้นไม่ได้แปลว่าการใส่ข้อมูลทุกอย่างลงไปพร้อมกันจะให้ผลค้นหาดีที่สุด
Matryoshka Embeddings ช่วยลดพื้นที่จัดเก็บได้อย่างไร
โมเดลส่งออกเวกเตอร์มาตรฐานที่ 768 มิติ แต่รองรับ Matryoshka Representation Learning (MRL) ซึ่งทำให้สามารถย่อเวกเตอร์ลงเป็น 512, 256 หรือ 128 มิติได้ โดยไม่ต้องฝึกโมเดลใหม่ เป้าหมายคือแลกคุณภาพบางส่วนกับพื้นที่จัดเก็บและความเร็วในการค้นหา
ในคู่มือนักพัฒนา Google ยกตัวอย่างว่าการเก็บเวกเตอร์ 1 ล้านรายการที่ 768 มิติด้วย bfloat16 ใช้พื้นที่ราว 1.5 GB ขณะที่ 128 มิติใช้ราว 250 MB หรือลดประมาณ 6 เท่า อย่างไรก็ตาม query และ document ต้องใช้จำนวนมิติเดียวกัน และเวกเตอร์ที่ตัดให้สั้นลงควรถูก normalize ใหม่ก่อนนำไปคำนวณ cosine similarity
ตัวอย่างแผนทดลองที่ KrobClick เสนอ: เตรียมคำค้นภาษาไทยกับรายการคำตอบที่ควรค้นพบ โดยมีทั้งคำตรง คำพ้อง และกรณีไม่มีข้อมูล ตรึงเอกสาร วิธีแบ่งข้อมูล และเกณฑ์ไว้ แล้วเปรียบเทียบ 768 กับ 128 มิติด้วย query/document ที่มีมิติตรงกันในแต่ละรอบ จดว่าคำตอบเป้าหมายอยู่ในผลค้นจำนวนที่กำหนดหรือไม่ พร้อมขนาดดัชนีและเวลา อย่าสรุปว่าคุณภาพเท่าเดิมจากการลดไฟล์ได้อย่างเดียว แผนนี้ยังไม่ได้รันกับโมเดลจริง
ตัวเลขพื้นที่ดังกล่าวเป็นการประมาณเฉพาะเวกเตอร์ ไม่ใช่ขนาดฐานข้อมูลทั้งหมด หากนับ bfloat16 ที่ 2 ไบต์ต่อมิติ หนึ่งล้านเวกเตอร์ขนาด 768 มิติใช้ 1,536,000,000 ไบต์ และ 128 มิติใช้ 256,000,000 ไบต์ ต่างกัน 6 เท่า ก่อนรวม index, metadata และสำเนาข้อมูล จึงต้องวัดพื้นที่ระบบจริงเพิ่ม
คุณภาพด้านโค้ดดีขึ้น แต่ benchmark ไม่ใช่คำตอบทั้งหมด
Google รายงานว่าคะแนน MTEB Code ของ EmbeddingGemma 2 เพิ่มจาก 68.76 ในรุ่นก่อนเป็น 78.68 หรือดีขึ้นประมาณ 14% เมื่อเทียบเชิงสัดส่วน และยังคงความสามารถด้านข้อความหลายภาษาไว้ในระดับใกล้เคียงรุ่นเดิม
ตัวเลข benchmark มีประโยชน์สำหรับเปรียบเทียบโมเดลภายใต้ชุดทดสอบเดียวกัน แต่ไม่ได้บอกโดยตรงว่าระบบค้นหาของแต่ละองค์กรจะดีขึ้นเท่าไร คุณภาพจริงยังขึ้นกับประเภทข้อมูล วิธีเขียน query วิธี chunk เอกสาร และเกณฑ์ประเมินของงานนั้น ๆ
งานแบบไหนที่ EmbeddingGemma 2 เหมาะเป็นพิเศษ
- ค้นหาไฟล์ในเครื่อง: ค้นหารูป เอกสาร เสียง หรือวิดีโอด้วยภาษาธรรมชาติ โดยเก็บทั้งการสร้าง embedding และฐานข้อมูลไว้บนอุปกรณ์
- RAG แบบ local: ใช้ EmbeddingGemma 2 สำหรับค้นหา context แล้วส่งข้อมูลที่เกี่ยวข้องให้โมเดลสร้างคำตอบ เช่น Gemma 4 โดยลดการส่งไฟล์ส่วนตัวขึ้นคลาวด์
- ค้นหาโค้ด: ใช้คำอธิบายธรรมดาเพื่อค้นหา function หรือไฟล์ที่มีหน้าที่ตามความหมาย เหมาะกับ codebase indexing และ agent ที่ต้องดึงโค้ดมาใช้อ้างอิง
- ค้นหาช่วงในวิดีโอหรือเสียง: สร้าง embedding จากเฟรมหรือช่วงเสียง แล้วค้นหาด้วยข้อความหรือสื่ออีกชนิดหนึ่ง
- Classification และ routing: เปรียบเทียบ embedding ของอินพุตกับคำอธิบายหมวดหมู่ เพื่อจัดเส้นทางงานแบบ zero-shot ในบางกรณี
ข้อดีของ on-device คือความเป็นส่วนตัว แต่ไม่ได้ทำให้ระบบปลอดภัยโดยอัตโนมัติ
การคำนวณ embedding ในเครื่องช่วยลดความจำเป็นในการส่งข้อมูลดิบไปยังเซิร์ฟเวอร์ จึงมีประโยชน์กับข้อมูลส่วนตัวและการทำงานออฟไลน์ รวมถึงอาจลด latency ของแอปที่ต้องค้นหาซ้ำบ่อย ๆ
อย่างไรก็ตาม การรันในเครื่องไม่ได้แก้ทุกปัญหา โมเดลอาจจัดอันดับผลลัพธ์ผิด มี bias หรือดึงข้อมูลที่ผู้ใช้ไม่ควรเห็น หากระบบจัดการสิทธิ์ไม่ดี Google เองระบุใน model card ว่าผู้พัฒนายังต้องประเมิน downstream application และเพิ่มมาตรการอย่าง retrieval filtering และ fairness testing ตามบริบทของงานจริง
สิ่งที่ควรเข้าใจก่อนเลือกใช้
EmbeddingGemma 2 น่าสนใจเพราะพยายามรวมหลายโมดัลไว้ในโมเดลขนาดต่ำกว่า 1 พันล้านพารามิเตอร์ แต่การเลือกใช้ควรเริ่มจากคำถามว่าแอปต้องค้นหาข้อมูลชนิดใด ต้องทำงานออฟไลน์หรือไม่ และยอมแลกคุณภาพกับหน่วยความจำหรือพื้นที่เก็บ vector ได้แค่ไหน หากงานมีแต่ข้อความ การโหลดเฉพาะ text encoder อาจเหมาะกว่า full multimodal ส่วนระบบที่ต้องค้นหารูป เสียง และวิดีโอร่วมกันจะได้ประโยชน์จาก shared embedding space มากกว่า
อีกจุดที่ต้องทดสอบเองคือ retrieval quality กับข้อมูลจริงขององค์กร เพราะ benchmark สาธารณะไม่สามารถแทนภาษาภายในบริษัท โค้ดเฉพาะทาง รูปแบบเอกสาร หรือเสียงในสภาพแวดล้อมของแต่ละระบบได้
ประเมินการค้นหาข้ามชนิดข้อมูลกับงานที่ใช้จริง
สาระสำคัญของ EmbeddingGemma 2 ไม่ได้อยู่ที่การเพิ่มโมเดล AI อีกหนึ่งรุ่น แต่คือการทำให้ search, RAG และ retrieval ข้ามข้อความ โค้ด ภาพ วิดีโอ และเสียงสามารถอยู่ในโมเดลขนาดเล็กพอสำหรับอุปกรณ์ผู้ใช้ได้มากขึ้น หากเครื่องมือ on-device และฮาร์ดแวร์รองรับดีขึ้น แนวทางนี้อาจช่วยให้แอปค้นหาและจัดระเบียบข้อมูลส่วนตัวได้ฉลาดขึ้น โดยไม่ต้องส่งข้อมูลทุกอย่างออกจากเครื่อง
แหล่งอ้างอิง
- Google DeepMind: EmbeddingGemma 2: an open, lightweight multimodal embedding model
- Google Developers Blog: EmbeddingGemma 2: The Developer Guide
- Google AI for Developers: EmbeddingGemma 2 model card
- Google for Developers
บทความนี้อ้างอิงประกาศและเอกสารของ Google ณ วันที่ 7 ตุลาคม 2569 ตัวเลข benchmark และประสิทธิภาพเป็นผลที่ผู้พัฒนารายงานและอาจแตกต่างตามฮาร์ดแวร์ ซอฟต์แวร์ และรูปแบบงานจริง บทความนี้ให้ความรู้ทั่วไป ไม่ใช่คำแนะนำทางการเงิน การลงทุน กฎหมาย หรือภาษีเฉพาะบุคคล ผู้อ่านควรตรวจสอบข้อมูลล่าสุดและพิจารณาสถานการณ์ของตนเองก่อนตัดสินใจ