
OpenRig คืออะไร? เจาะสถาปัตยกรรม Multi-Agent สำหรับ Claude Code, Codex และทีม AI ที่ทำงานต่อเนื่อง
ถ้าคุณเริ่มมี Claude Code หรือ Codex หลายหน้าต่างจนไม่รู้ว่าใครกำลังทำอะไร ปัญหาไม่ได้อยู่ที่โมเดลอย่างเดียว แต่อยู่ที่การประสานงาน OpenRig พยายามแก้จุดนี้ด้วยแนวคิดว่า agent แต่ละตัวควรมีบทบาท ที่อยู่ เจ้าของงาน และกลไกส่งต่องานแบบถาวร บทความนี้จะเจาะตั้งแต่สถาปัตยกรรมภายใน ไปจนถึง use case ที่เหมาะจริงและข้อจำกัดที่ควรรู้ก่อนสร้างทีม AI หลาย agent
OpenRig คืออะไร และแก้ปัญหาอะไร
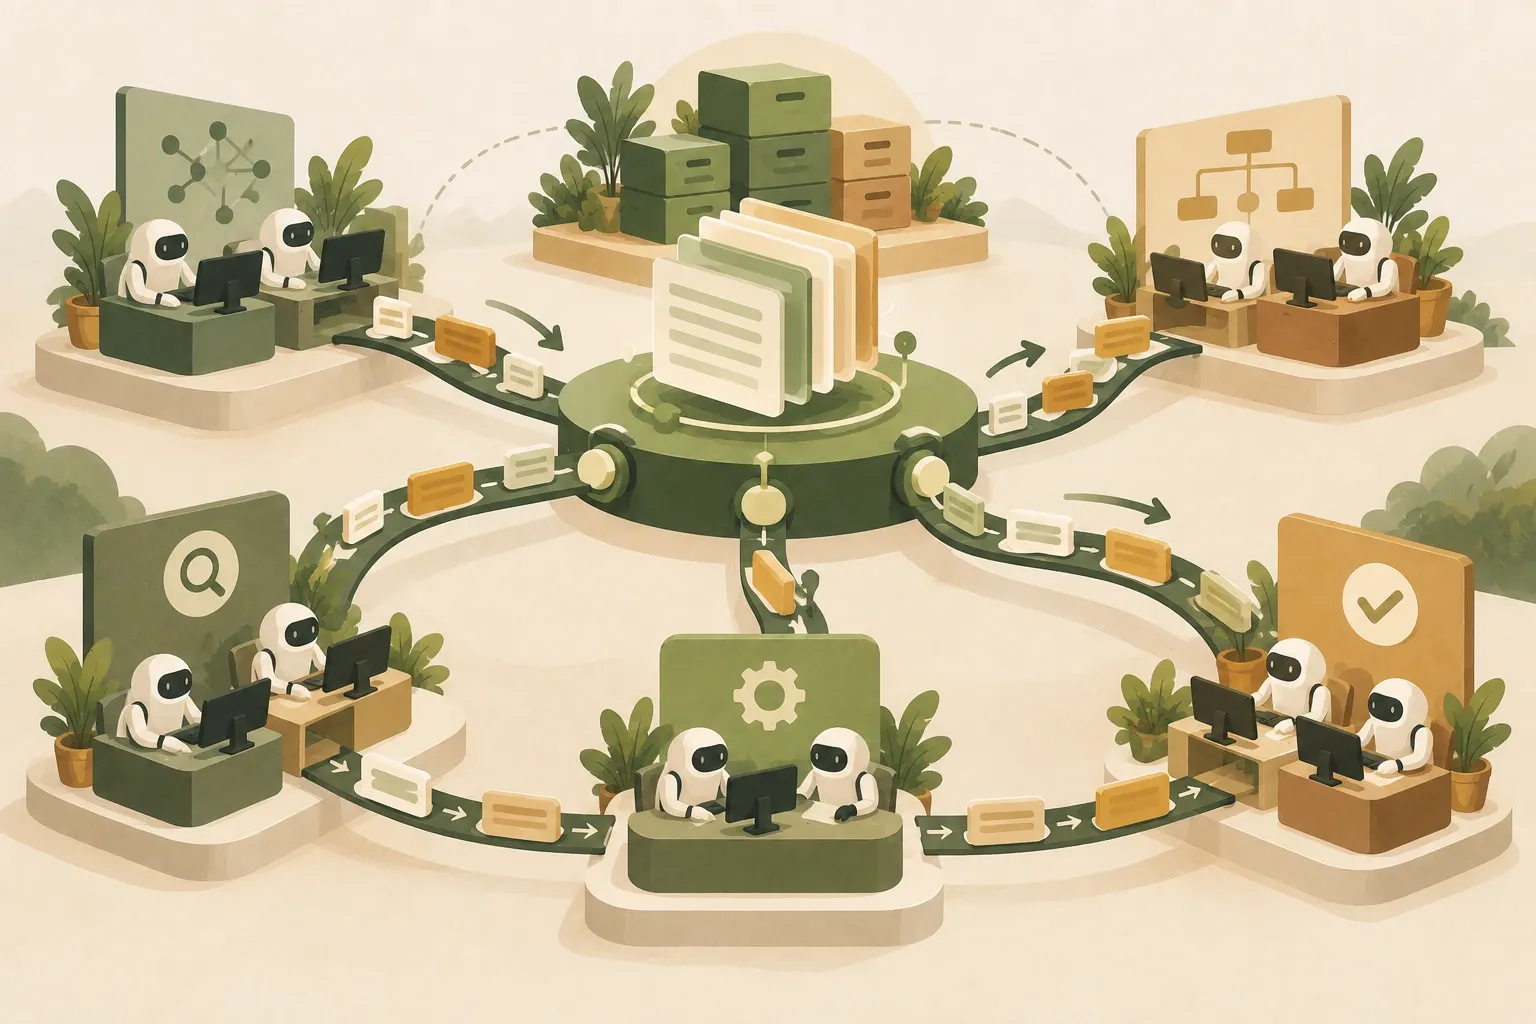
OpenRig ไม่ได้เป็นโมเดล AI ตัวใหม่ และไม่ใช่ agent framework ที่มาแทน Claude Code หรือ Codex โดยตรง แต่มันทำหน้าที่เป็น control plane หรือ multi-agent harness ที่ครอบ harness หลายตัวอีกชั้นหนึ่ง เป้าหมายคือเปลี่ยนการเปิด agent หลาย terminal แบบแยกกัน ให้กลายเป็น “ทีม” ที่มีโครงสร้าง บทบาท ที่อยู่ การส่งต่องาน และสถานะที่ตรวจสอบได้
แนวคิดสำคัญคือ agent แต่ละตัวไม่ควรเป็นเพียง process ชั่วคราวที่หายไปเมื่อปิด session แต่ควรมี seat หรือ “ตำแหน่งงาน” ที่มีชื่อและหน้าที่คงที่ เช่น agent สำหรับ implementation, QA, review หรือ research เมื่อ session เดิมจบ seat เดิมยังอยู่ และสามารถรับ session ใหม่กลับมาทำงานต่อจากบริบทที่บันทึกไว้ได้
OpenRig จึงเหมาะกับปัญหาที่เริ่มเกิดเมื่อเราใช้ coding agent มากกว่าหนึ่งตัวพร้อมกัน เช่น ใครเป็นเจ้าของงานนี้ ใครต้อง review ต่อ งานค้างอยู่ตรงไหน ถ้า agent context เต็มแล้วเปลี่ยน session จะส่งต่องานอย่างไร และจะทำอย่างไรให้ Claude Code กับ Codex ทำงานร่วมกันโดยไม่ต้องให้มนุษย์คอย copy-paste context ระหว่าง terminal ตลอดเวลา
สถาปัตยกรรม: tmux เป็นช่องทางสื่อสาร แต่ SQLite และไฟล์คือแหล่งความจริง
เอกสารสถาปัตยกรรมของ OpenRig อธิบายชัดว่า tmux เป็น transport ไม่ใช่ source of truth ตัวระบบใช้ tmux เพื่อเข้าถึง terminal ของ agent ส่งข้อความ และอ่าน output แต่สถานะถาวรของ rig งาน และประวัติการเปลี่ยนสถานะถูกเก็บใน SQLite และ filesystem หากสิ่งที่เห็นใน terminal ขัดกับสถานะในฐานข้อมูล OpenRig ถือฐานข้อมูลเป็นหลัก
ในภาพรวม OpenRig ประกอบด้วย daemon ที่รันในเครื่อง, CLI/TUI สำหรับผู้ใช้, MCP tools สำหรับให้ agent ควบคุม topology ของตัวเอง, SQLite สำหรับสถานะถาวร และ runtime adapters ที่เชื่อมกับ harness อย่าง Claude Code หรือ Codex จุดที่น่าสนใจคือ OpenRig ไม่พยายามซ่อน terminal เดิมของ agent แต่ยังให้เรา attach เข้า tmux เพื่อดู agent ทำงานจริงได้เมื่อจำเป็น
แนวทางนี้ต่างจากระบบ agent orchestration ที่ซ่อนทุกอย่างหลัง API เพราะ OpenRig ยอมรับว่า coding agent ที่ใช้งานจริงจำนวนมากมีชีวิตอยู่ใน CLI อยู่แล้ว จึงสร้าง control plane รอบ terminal เหล่านั้นแทนที่จะบังคับให้ย้าย workflow ทั้งหมดเข้า runtime ใหม่
Rig, Pod, Seat และ AgentSpec: หน่วยพื้นฐานของ “องค์กร AI”
- Rig: ทีมทั้งหมดที่สร้างขึ้นเพื่อเป้าหมายหนึ่ง เช่น product team หรือ research team ถูกนิยามด้วยไฟล์
rig.yamlและสามารถเปิด ปิด snapshot และ restore เป็นหน่วยเดียว - Pod: กลุ่ม agent ที่มี context ใกล้กัน เช่น development, review หรือ research ใช้เป็นขอบเขตความรู้และการประสานงาน
- Seat: ตำแหน่งถาวรใน rig เช่น implementer หรือ reviewer ตัว session ที่นั่งใน seat เปลี่ยนได้ แต่ชื่อ บทบาท และบริบทที่สะสมของตำแหน่งยังอยู่
- AgentSpec: blueprint ของ agent หนึ่งประเภทใน
agent.yamlระบุ skill, guidance, startup behavior และ profile ที่ใช้ซ้ำได้ - RigSpec: blueprint ของทั้งทีม ระบุ pod, member, edge, startup, permission policy และ continuity policy
- RigBundle: ไฟล์ archive สำหรับย้าย topology พร้อม AgentSpec และ resource ที่เกี่ยวข้องไปอีกเครื่อง โดยมี SHA-256 integrity checks
จุดสำคัญคือ OpenRig แยก “ตัวตนของบทบาท” ออกจาก “session ที่กำลังรัน” คล้ายองค์กรจริงที่ตำแหน่ง Backend Engineer ยังอยู่แม้พนักงานคนเดิมออกจากงาน ในโลก agent สิ่งนี้ช่วยให้ระบบไม่ผูกความรู้และงานทั้งหมดไว้กับ context window เดียว
Queue ทำให้การส่งต่องานไม่หายไปในแชต
การส่งข้อความหา agent อีกตัวด้วย rig send เหมาะกับคำถามหรือการแจ้งข้อมูล แต่ข้อความอย่างเดียวไม่ใช่ระบบเจ้าของงาน เมื่อมี agent หลายตัว ข้อความสามารถถูกฝังใน history หรือไม่มีใครรู้ว่าควรทำต่อเมื่อไร
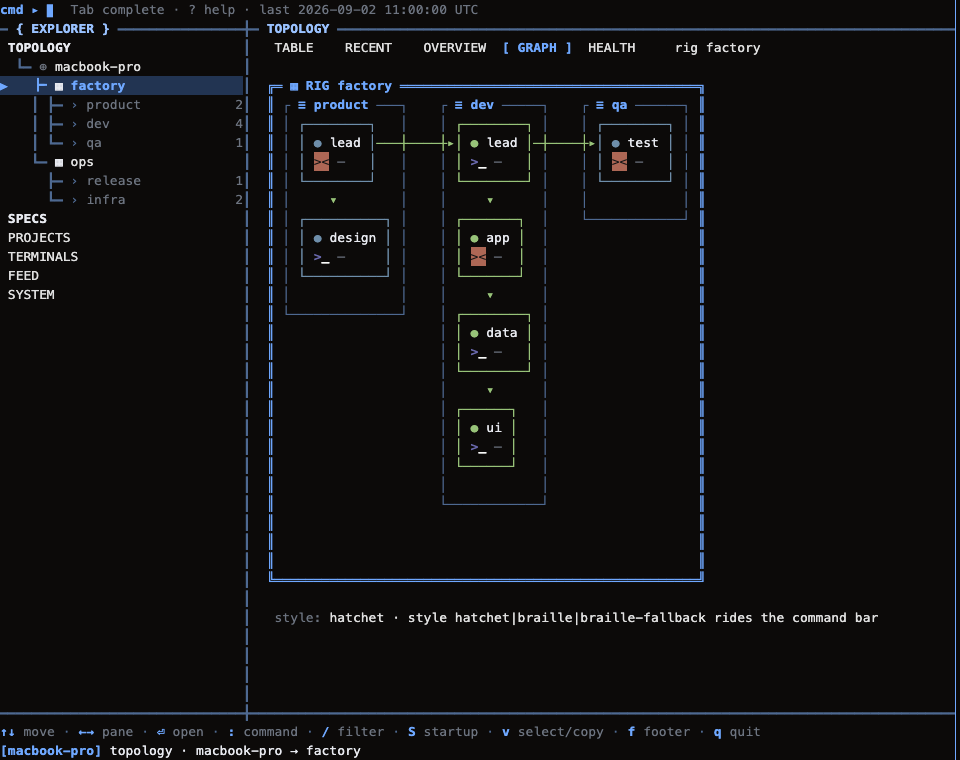
OpenRig จึงมี queue ที่ถือ “หนึ่งหน่วยงานที่มีเจ้าของ” แต่ละรายการมี destination seat, เนื้อหางาน, state และประวัติการเปลี่ยนสถานะแบบ append-only งานยังอยู่แม้ turn ของ agent จบ context ถูก compact หรือ session ถูกแทนที่ ที่สำคัญ การ handoff สามารถปิดงานของผู้ส่งและเปิด successor ให้ผู้รับใน transaction เดียว ลดช่องว่างที่งานอาจตกหล่นระหว่างสอง agent
อย่างไรก็ตาม เอกสารของ OpenRig เตือนว่า durable ไม่ได้แปลว่า automatic queue ทำให้มีหลักฐานว่างานอยู่ที่ใครและผ่านอะไรมา แต่ไม่ได้รับประกันว่า agent จะตื่นขึ้นมาเห็นงานเองเสมอ จึงยังต้องมี notification, watchdog หรือมนุษย์/peer ที่คอยกระตุ้นตามความเหมาะสม
Workflow และ Watchdog: เมื่อการส่งต่องานต้องเป็นลำดับที่ทำซ้ำได้
ถ้า queue คือ “ใครถือชิ้นงานนี้อยู่” workflow คือ “ชิ้นงานควรเดินผ่านขั้นตอนไหนบ้าง” ตัวอย่างเช่น Planner → Implementer → QA → Reviewer ระบบเก็บ active step และ owner ไว้เป็น durable state เมื่อเจ้าของปิด step ระบบสามารถสร้าง queue item ของ step ถัดไปใน transaction เดียว
Watchdog เป็นกลไกที่ช่วยจัดการเรื่องเวลาและการรอ เพราะ agent ไม่ได้ปลุกตัวเองได้เสมอ งาน watchdog ถูกเก็บในฐานข้อมูลและอยู่ต่อหลัง daemon restart สามารถใช้เตือนตามเวลา รอ artifact รอ queue ว่าง หรือเฝ้าการใช้ context ของ seat ก่อนชน context wall ได้
เมื่อนำ rig, queue, workflow และ watchdog มารวมกัน เราจะได้ระบบที่ใกล้ “software factory” มากขึ้น เพราะงานไม่ต้องอาศัยมนุษย์จำทุก handoff แต่ยังมี state ที่ตรวจสอบย้อนกลับได้ว่าตอนนี้ workflow อยู่ขั้นใด
Continuity: ทำไม OpenRig ถึงต่างจากการเปิด agent หลายหน้าต่าง
ปัญหาของ coding agent ที่ทำงานนานคือ context window มีขีดจำกัด session อาจล้ม process อาจปิด หรือเครื่องอาจ restart OpenRig แยก seat ออกจาก session จึงสร้างกลไก continuity เพื่อพยายามรักษาตำแหน่งงานให้ทำต่อได้ เช่น snapshot/restore ทั้ง rig, handover ของ seat, restore brief และการเตรียมตัวก่อน compaction
แนวคิดที่ดีคือระบบพยายามรายงานการ restore อย่างตรงไปตรงมา ไม่ควรบอกว่า “กู้คืนสำเร็จ” หากจริง ๆ แล้วเป็นการเริ่ม agent ใหม่แบบไม่มีบริบท เอกสารระบุผลลัพธ์ต่อ seat ว่า resumed, rebuilt, fresh หรือ failed เพื่อให้ operator รู้ว่าสภาพของแต่ละตำแหน่งจริง ๆ เป็นอย่างไร
Use Case 1: Product Team สำหรับพัฒนาฟีเจอร์แบบครบวงจร
Starter product-team ของ OpenRig เป็นตัวอย่างชัดที่สุด มี 3 pod และ 7 seat แบ่ง orchestration, development และ review โดย development มี implementer, QA และ product designer ขณะที่ review ใช้ reviewer อิสระสองตัว แนวคิดคือแยก “สร้าง” กับ “ตรวจ” ออกจากกันแทนที่จะให้ agent ตัวเดียวเขียนโค้ดแล้วตรวจตัวเอง
รูปแบบนี้เหมาะกับงาน full-stack ที่มี requirement หลายด้าน เช่น เพิ่มระบบ subscription ใหม่หนึ่งชุด: orchestrator ช่วยแตกงาน, implementer ทำ backend/frontend, designer ตรวจ UX, QA ทดลอง user flow และ reviewer ตรวจ architecture หรือ regression ก่อนสรุปกลับให้มนุษย์ตัดสินใจ
ข้อดีไม่ได้อยู่ที่จำนวน agent มาก แต่คือ การแยก concern และจุด handoff ที่ชัด เอกสารของ OpenRig เองแนะนำว่า ถ้างานเล็กเพียง refactor module เดียว ไม่จำเป็นต้องใช้ 7 seat เริ่มจากหนึ่งหรือสอง agent แล้วเพิ่ม topology เมื่อ coordination เริ่มมีมูลค่าจริงจะเหมาะกว่า
Use Case 2: Implementation + QA สำหรับทีมเล็กที่ต้องการ “คนทำ” และ “คนเช็ก”
หาก product-team ใหญ่เกินไป OpenRig มี starter implementation-pair สำหรับ implementer กับ QA โดยตรง รูปแบบนี้เหมาะกับ solo developer ที่อยากรักษาความเรียบง่าย แต่ไม่ต้องการให้ coding agent ตัวเดียวเป็นทั้งผู้สร้างและผู้รับรองงานของตัวเอง
ตัวอย่างเช่นให้ implementer แก้ bug ใน checkout flow แล้ว handoff ให้ QA ทดสอบ acceptance criteria, edge case และ regression หาก QA พบปัญหา งานสามารถส่งกลับไปยัง implementer พร้อม context ที่เฉพาะเจาะจงกว่าเดิม รูปแบบนี้มี overhead ต่ำกว่า product-team และเป็นจุดเริ่มต้นที่เหมาะสำหรับคนที่เพิ่งทดลอง multi-agent
Use Case 3: Adversarial Review ให้สองโมเดลหาจุดพลาดคนละแบบ
OpenRig มี starter adversarial-review ที่แยก lead กับ reviewer อิสระสองตัว และแนวทางในเอกสารยังสนับสนุนการผสม runtime ต่างชนิดกัน จุดประสงค์คือไม่ให้ reviewer แชร์ bias เดียวกันทั้งหมด
คู่มือ Claude vs Codex ของโครงการระบุจากประสบการณ์ของผู้สร้างว่า Claude และ Codex มักมีจุดแข็งและ failure mode ต่างกัน จึงเหมาะกับการใช้ตรวจงานเดียวกันจากคนละมุม แม้ข้อสังเกตเรื่อง “โมเดลไหนเก่งอะไร” จะเปลี่ยนตามรุ่นได้ แต่หลักการที่กว้างกว่านั้นยังน่าสนใจ: diversity ของ reviewer มีค่าเมื่อข้อผิดพลาดแต่ละชนิดไม่ทับซ้อนกัน
Use case นี้เหมาะกับ pull request สำคัญ, migration, authentication, permission logic หรือโค้ดที่ต้องการความมั่นใจสูงกว่างานทั่วไป โดยให้ reviewer แต่ละตัวตรวจอย่างอิสระก่อน lead รวมข้อค้นพบ
Use Case 4: Research Team แยก “หาข้อมูล” ออกจาก “สังเคราะห์ข้อสรุป”
OpenRig มี starter research-team ที่ประกอบด้วย lead, analyst และ synthesizer รูปแบบนี้ไม่ได้จำกัดอยู่ที่การเขียนโค้ด เพราะปัญหาหลายอย่างในงาน software เริ่มจากการหาคำตอบ เช่น เปรียบเทียบ library, ประเมิน architecture, วิเคราะห์ incident หรือสำรวจ API ใหม่
การแยก analyst ออกจาก synthesizer มีประโยชน์เมื่ออยากให้คนหนึ่งเน้นรวบรวมหลักฐานและอีกคนหนึ่งเน้นตรวจความสอดคล้อง จัด trade-off และเขียน recommendation สิ่งนี้ลดโอกาสที่ agent ผู้หาข้อมูลจะยึดติดกับสมมติฐานแรกของตัวเองมากเกินไป
สำหรับทีมจริง สามารถต่อยอดเป็นหลาย analyst แยกหัวข้อ เช่น security, performance, cost และ developer experience แล้วให้ synthesizer สรุปผลกลับ lead พร้อมประเด็นที่ยังไม่แน่นอน
Use Case 5: Specialist ที่อยู่กับโปรเจกต์เป็นเดือน ไม่ต้องอธิบายเรื่องเดิมซ้ำ
หน้าเว็บของ OpenRig เน้น use case ที่น่าสนใจมากคือ “Ask the specialist” เมื่อโปรเจกต์มีการตัดสินใจสะสมเป็นเดือน seat บางตัวอาจรู้ subsystem หนึ่งดีกว่า agent ที่เพิ่งเกิดใหม่ เช่น agent ที่รับผิดชอบ shared client, database schema หรือ deployment pipeline
แทนที่จะเปิด agent ใหม่แล้วโยนเอกสารทั้งหมดให้ทุกครั้ง seat แบบ persistent สามารถรักษา role และบริบทที่จัดเก็บไว้ จากนั้น agent อื่นส่งคำถามหา specialist โดยตรง หากเป็นเพียงคำถามสั้น ๆ อาจใช้ message โดยไม่ต้องสร้าง queue item ใหม่
แนวคิดนี้เหมาะกับ codebase ใหญ่ที่ knowledge กระจายเป็น domain เช่น frontend, backend, data, infra และ security เพราะ topology ช่วยบอกว่า “ควรถามใคร” แทนที่จะหวังว่า agent ตัวเดียวจะรู้ทุกอย่าง
Use Case 6: Agent-Managed Software — ให้ specialist ดูแล service จริง
OpenRig ไม่ได้จำกัดว่า rig ต้องประกอบด้วย agent อย่างเดียว RigSpec รองรับ managed service ผ่าน Docker Compose และตัวอย่างที่โครงการแจกคือ secrets-manager ซึ่งใช้ HashiCorp Vault พร้อม specialist agent
ในรูปแบบนี้ agent ไม่ได้เพียงแก้ source code แต่ทำหน้าที่ operator ของ software ที่ถูกแพ็กมาพร้อม rig เช่น ตรวจ health, อ่านสถานะ หรือทำงานตาม runbook แนวคิดนี้เปิดทางสู่ use case เช่น database operator, local test environment, observability stack หรือ internal tool ที่มี agent ดูแลประจำ แต่การนำไปใช้กับระบบ production จริงต้องออกแบบ permission และ guardrail อย่างระมัดระวัง
Use Case 7: Architecture Roundtable และการตัดสินใจข้ามทีม
เอกสาร “What is a rig?” ยกตัวอย่างการดึง agent จากหลาย pod มารวมเป็น tiger team เพื่อประชุมเรื่อง architecture เช่น implementer นำข้อจำกัดของ code, researcher นำข้อมูลเทคโนโลยี และ reviewer นำ failure mode มาคุยร่วมกัน
สิ่งที่ได้ไม่ใช่เพียงการถามโมเดลหลายครั้ง แต่เป็นการให้ agent ที่ถือ context คนละ domain เข้ามาแลกข้อมูล โดยยังกลับไปยัง seat เดิมหลังจบการตัดสินใจ รูปแบบนี้เหมาะกับเรื่องที่ไม่มีคำตอบเดียว เช่น เลือก database, ออกแบบ permission boundary, แบ่ง service หรือวาง migration plan
Use Case 8: Dogfooding และ Recursive Improvement Loop
ผู้สร้าง OpenRig เล่าว่าเคยเชื่อม build rig, product-management rig และ dogfood rig เข้าด้วยกัน ให้ dogfood system ส่ง feedback กลับ product management แล้ววนกลับไปสู่การพัฒนา เป็นรูปแบบ recursive self-improvement ของซอฟต์แวร์
กรณีนี้แสดงศักยภาพของการมี workflow, persistent team และ watchdog แต่ก็เป็นจุดที่ต้องระวังมากที่สุด ผู้สร้างระบุเองว่าภายหลังลดระดับ autonomy ลง เพราะต้องการ guardrail ที่ดีกว่าก่อนปล่อย loop ลักษณะนี้กับ public project นี่เป็นบทเรียนสำคัญว่า multi-agent orchestration ทำให้ agent ทำงานต่อเนื่องได้จริง แต่ยิ่ง loop ยาว การควบคุม intent, permission และ acceptance criteria ยิ่งสำคัญ
Use Case 9: Simulated Focus Group สำหรับ UX และ Product Discovery
เอกสารของ OpenRig ยังเสนอ pattern ที่ไม่ใช่ coding โดยตรง เช่นให้ agent หนึ่งสาธิตผลิตภัณฑ์ อีก agent เล่นบทผู้ใช้ และ agent ที่สามสังเกตพร้อมเขียนรายงาน จากนั้นทำซ้ำหลายรอบเพื่อหา pattern ของ friction หรือ misunderstanding
สิ่งนี้ควรถูกมองเป็น simulation เพื่อสร้างสมมติฐาน ไม่ใช่ตัวแทน research กับผู้ใช้จริง เพราะ agent ไม่ได้มีประสบการณ์ ความต้องการ และข้อจำกัดแบบมนุษย์จริง แต่สำหรับการหา edge case ก่อน usability test หรือสร้าง checklist สำหรับ dogfooding วิธีนี้อาจช่วยขยายพื้นที่สำรวจได้เร็ว
มีการใช้จริงแค่ไหน: หลักฐานจาก Community Field Report
นอกจากตัวอย่างจากผู้สร้าง ยังมี field report ใน GitHub Issue #227 ที่ผู้ใช้รายหนึ่งรายงานการรัน OpenRig v0.6.2 ต่อเนื่อง 3 วันบนสอง host ด้วย development factory 9 seat และ kernel rig โดยใช้ OpenCode adapter ที่ cherry-pick จาก pull request ที่ยังไม่ได้ merge เข้าหลัก รายงานระบุว่าใช้งาน unattended ได้ในระดับหนึ่งแต่เจอ operational gaps ที่ต้องแก้เองหลายจุด
กรณีนี้มีประโยชน์ในฐานะสัญญาณว่า architecture แบบ persistent fleet สามารถถูกนำไปใช้นอก demo ได้ แต่ไม่ควรตีความว่า OpenCode adapter เป็นฟีเจอร์มาตรฐานของ OpenRig เพราะผู้รายงานระบุชัดว่าเป็น branch ที่นำโค้ดทดลองมารวมเอง และผลลัพธ์ของ setup นั้นไม่ใช่การรับรองความเสถียรของ release ปกติ
OpenRig ต่างจาก Subagent อย่างไร
Subagent ภายใน Claude Code หรือ harness อื่นมักเหมาะกับงานย่อยชั่วคราว: agent หลักแตกงานให้ helper ไปค้นไฟล์ เขียน test หรือวิเคราะห์ส่วนหนึ่ง แล้วนำผลกลับมารวมใน session เดิม OpenRig ไม่ได้แทนกลไกนี้ แต่เพิ่มอีกชั้นสำหรับ agent ที่ควรมีตัวตนและ ownership ระยะยาว
หน้าเว็บ OpenRig อธิบายตัวอย่างที่ durable specialist แต่ละ seat ยังสามารถเรียก temporary native subagent ของตัวเองได้ด้วย กล่าวคือสองระดับสามารถอยู่ร่วมกัน: OpenRig จัดทีมหลักที่มี owner และ queue ส่วน subagent ช่วยทำงานย่อยระยะสั้นใน context ของแต่ละ specialist
เกณฑ์ง่าย ๆ คือ ถ้างานย่อยใช้เวลาไม่นานและไม่ต้องมีเจ้าของหลัง session จบ ใช้ subagent มักพอ แต่ถ้าบทบาทนั้นต้องรับงานซ้ำ มีประวัติการตัดสินใจ ต้องถูก agent อื่นเรียกหา หรือจำเป็นต้อง handoff งานข้ามวัน seat แบบ OpenRig เริ่มมีความหมาย
จุดแข็งของ OpenRig
- Cross-harness: ออกแบบให้ agent จาก harness ต่างกันอยู่ใน topology เดียวกัน ลดการล็อกตัวเองกับโมเดลชนิดเดียว
- Durable ownership: Queue และ workflow ทำให้งานมีเจ้าของและประวัติ ไม่หายไปกับ chat history
- Persistent identity: Seat มีชื่อและบทบาทคงที่ แม้ session เปลี่ยน ทำให้สร้าง specialist ระยะยาวได้
- Local-first: control plane หลักรันในเครื่องและใช้ terminal เดิมของ agent ทำให้ inspect ได้โดยตรง
- Declarative topology: RigSpec และ AgentSpec ทำให้ทีม version-control, ทำซ้ำ และแชร์ได้คล้าย infrastructure-as-code
- Human can drop down: เมื่อ orchestration มีปัญหา ผู้ใช้ยังเข้า terminal ของ agent แต่ละ seat เพื่อตรวจสอบหรือแทรกแซงได้
คำว่า local-first ในที่นี้หมายถึงระบบควบคุมทีมและสถานะงาน ไม่ได้ยืนยันว่าข้อความหรือโค้ดไม่ออกจากเครื่อง เอกสาร Architecture แยกไว้ว่า coding harness ใช้ provider ที่แต่ละตัวตั้งค่า จึงต้องตรวจเส้นทางส่งข้อมูลของแต่ละ seat รวมถึง MCP, telemetry และบริการเสริม ก่อนให้ agent อ่านโค้ดหรือเอกสารภายใน
ข้อจำกัดและความเสี่ยงที่ควรรู้ก่อนใช้
OpenRig ยังเป็นโครงการก่อน 1.0 และผู้ดูแลระบุว่าให้คาดหวัง rough edges ได้ ข้อจำกัดแรกคือ operational complexity: เมื่อมีหลาย seat ปัญหาไม่ได้มีเพียง “agent ตอบผิด” แต่เพิ่มเรื่อง queue ค้าง, context drift, model throttling, startup configuration และ handoff ที่ไม่สมบูรณ์
ด้าน environment เอกสารปัจจุบันเน้น macOS และ Linux พร้อม Node.js รุ่นที่รองรับและ tmux ขณะที่ native Windows ยังไม่รองรับ และ WSL2 ยังไม่ได้รับการทดสอบอย่างเป็นทางการในคู่มือที่ตรวจสอบ นอกจากนี้จำนวน seat ที่รันพร้อมกันเพิ่มการใช้ quota และอาจชน provider throttling ได้เร็ว โดยเฉพาะ topology ใหญ่
ด้าน permission ต้องระวังเป็นพิเศษ เพราะ OpenRig เชื่อม agent กับ terminal และสามารถตั้งค่า runtime เพื่อให้ทำงานร่วมกันได้ rig setup อาจแก้ไฟล์ configuration และ workspace trust ของ provider เอกสารแนะนำให้ดู dry run และรู้ว่าระบบจะเปลี่ยนไฟล์ใดก่อนยอมรับการตั้งค่า
อีกจุดคือ topology บางส่วนยังเป็น “คำอธิบายความสัมพันธ์” มากกว่าการบังคับ policy จริง เช่น edge ประเภท can_observe, collaborates_with และ escalates_to เป็น informational ใน schema ปัจจุบัน จึงไม่ควรสมมติว่าการเขียนเส้นไว้ใน YAML เท่ากับมี security boundary หรือ authorization enforcement
สุดท้าย multi-agent ไม่ได้ทำให้คำตอบถูกขึ้นโดยอัตโนมัติ ถ้า requirement ไม่ชัด agent หลายตัวอาจช่วยกันขยายความผิดพลาดได้เร็วกว่าเดิม การมี review pod, acceptance criteria, proof และ human escalation จึงสำคัญกว่าเพียงเพิ่มจำนวน agent
ใครควรใช้ OpenRig และใครยังไม่จำเป็น
OpenRig เหมาะกับคนที่เริ่มพบว่า agent หลายตัวมี “ต้นทุนการประสานงาน” สูงกว่าต้นทุนการเรียกโมเดล เช่น ต้อง copy context ระหว่าง terminal, งานตกหล่น, ไม่มี reviewer อิสระ, โปรเจกต์ลากหลายวัน หรืออยากให้ specialist กลับมาทำงานเดิมซ้ำโดยไม่เริ่มจากศูนย์
ถ้าคุณยังใช้ agent ตัวเดียวทำ task สั้น ๆ หรือเปิดสอง terminal เป็นครั้งคราว OpenRig อาจเพิ่มระบบมากเกินประโยชน์ เพราะต้องดูแล daemon, tmux, topology และ state เพิ่ม การเริ่มจาก agent หนึ่งตัวหรือคู่ implementer+reviewer แล้วค่อยโตตาม pain point เป็นแนวทางที่สอดคล้องกับคำแนะนำของโครงการมากกว่าเริ่มด้วย fleet ขนาดใหญ่
วิธีเริ่มทดลอง OpenRig กับทีมขนาดเล็ก
โจทย์ทดลองสมมติสำหรับ implementation-pair: ให้ implementer แก้เครื่องอ่าน CSV เพื่อรักษารหัส 00123 แล้วส่ง path ของ diff, ตัวอย่างข้อมูล และผลตรวจให้ QA เกณฑ์รับงานคือรหัสยังมีศูนย์นำหน้าและข้อมูลอื่นไม่ถูกเปลี่ยน ถ้า QA พบว่ารหัสกลายเป็น 123 ให้ส่งข้อที่ไม่ผ่านกลับพร้อมไฟล์และเงื่อนไข ไม่ปิดงานเพียงเพราะผู้ทำรายงานว่าเสร็จ หลังเปลี่ยน session ให้ตรวจ owner และ artifact จากสถานะจริงอีกครั้ง ตัวอย่างนี้เป็นแผนตรวจ workflow ไม่ใช่ผลทดสอบ OpenRig ของ KrobClick และไม่อนุญาตให้ push หรือ deploy อัตโนมัติ
วิธีเริ่มที่มีเหตุผลคือเลือกงานเล็กหนึ่งชิ้นที่ตรวจผลได้ชัด เช่นแก้ feature เล็กหรือ bug หนึ่งตัว ให้ agent หนึ่งตัวเป็น owner และอีกตัวเป็น checker จากนั้นสังเกตว่าการมี durable queue และ seat ช่วยจริงหรือไม่ เมื่อเริ่มมีงานขนานค่อยเพิ่ม builder หรือ reviewer และเมื่อพบว่าการส่งต่องานมี pattern ซ้ำจึงค่อยสร้าง workflow
ก่อนเพิ่ม autonomy ควรกำหนด 4 อย่างให้ชัด: outcome ที่ต้องการ, acceptance criteria, ขอบเขต permission และจุดที่ต้องถามมนุษย์ ถ้าสี่อย่างนี้ยังไม่ชัด การเพิ่มจำนวน agent จะเพิ่มความเร็วในการสร้าง output แต่ไม่ได้เพิ่มความมั่นใจว่าระบบกำลังเดินไปในทิศที่ถูกต้อง
OpenRig น่าสนใจเพราะแก้ “ปัญหาองค์กร” มากกว่าปัญหาโมเดล
สิ่งที่ทำให้ OpenRig แตกต่างไม่ใช่การมี agent หลายตัว เพราะ Claude Code และ Codex ต่างก็มีวิธีสร้าง helper ของตัวเองอยู่แล้ว จุดเด่นคือการมอง agent เป็นสมาชิกทีมที่ต้องมี identity, ownership, communication, continuity และ workflow เหมือนระบบงานระยะยาว
เมื่อใช้ AI coding หลายบทบาท ต้องรู้ว่าใครมีสิทธิ์ทำอะไร งานอยู่กับใคร เก็บความรู้ไว้ที่ไหน และจะกู้การทำงานอย่างไรหาก context หรือ process หายไป OpenRig ทดลองจัดการเรื่องเหล่านี้ผ่านทีมที่มีสถานะต่อเนื่อง ปัจจุบันยังเหมาะกับผู้ที่รับความซับซ้อนและข้อจำกัดของระบบก่อน 1.0 ได้ มากกว่าผู้ใช้ทั่วไป
แหล่งข้อมูล
- GitHub: mvschwarz/openrig — Multi-agent harness for persistent coding-agent teams
- OpenRig Docs: Architecture
- OpenRig Docs: Coordination — assigning tasks to agents
- OpenRig Docs: Continuity — seats that outlive their sessions
- OpenRig Docs: Workflows and watchdogs
- OpenRig Specification: RigSpec Reference
- OpenRig Guide: The Full Product Team
- OpenRig Blog: The building blocks of a software factory are simple
- OpenRig Docs: What is a rig?
- GitHub Issue #227: Community field report using OpenRig with an experimental OpenCode adapter
บทความนี้อ้างอิงเอกสารและซอร์สของ OpenRig ที่ตรวจสอบเมื่อ 7 ตุลาคม 2569 ซึ่งโครงการยังอยู่ก่อนเวอร์ชัน 1.0 รายละเอียดคำสั่ง runtime และข้อจำกัดอาจเปลี่ยนได้ ควรตรวจเอกสารของเวอร์ชันที่ติดตั้งจริงก่อนใช้งาน